Nutanix Technology Champion - Nutanix Solution Architect

Julien DUMUR
Infrastructure in a Nutshell

NKP (Nutanix Kubernetes Platform) figurait sur ma roadmap 2025, je l’ai repoussé à 2026 faute de temps, et cette année chaotique vient de le renvoyer à 2027. Je n’ai donc pas touché à NKP 2.19 : ce que je vous raconte ici vient des sessions de Yannick Struyf et de Divyansh, suivies le 26 octobre à San Jose pendant le Nutanix Tech Connect 2026, où peu de personnes présentes dans la salle avaient testé cette version sortie la semaine précédente.

Dans cet article, je vous partage ce que j’ai retenu de NKP Metal et de CN-AOS, les deux annonces qui font sortir NKP de l’hyperviseur, en les confrontant à la documentation disponible. Si un acronyme vous échappe en route, je vous invite à consulter mon lexique Nutanix.

NKP Metal, du Kubernetes sur serveurs physiques
Yannick Struyf, Principal Product Manager NKP, présentant NKP Metal et les nouveautés de NKP 2.19


Annoncé au .NEXT d’avril dernier, NKP Metal arrive avec NKP 2.19 et déploie Kubernetes directement sur des serveurs physiques, dans les éditions Pro et Ultimate. Yannick, Principal Product Manager NKP, y voit trois usages : les machines denses en GPU que les clients veulent exploiter sans couche intermédiaire, l’edge, où les applications sont désormais majoritairement conteneurisées, et les serveurs à réutiliser après une sortie de VMware.

L’installation passe par un outil connu. Foundation Central découvre les nœuds et y dépose une image Ubuntu durcie, téléchargée sur le portail Nutanix, sur du matériel validé qui se limite pour l’instant à Dell et HPE, la liste devant s’allonger à chaque version. Si vous ne connaissez pas Foundation, je vous invite à consulter mon article sur le sujet.

Foundation ne sert qu’au démarrage. Les mises à jour de l’OS et le scaling passent ensuite par NKP, qui met à jour les serveurs existants, faute d’en avoir souvent en réserve, et s’appuie sur des labels (« nœud GPU », « datacenter 1″…) pour ajouter automatiquement des machines quand une application grossit.

Un NTC (Nutanix Technology Champion) a posé la question qui fâche : le bare metal est-il vraiment plus performant, alors que certains rapports côté VMware affirment le contraire ? Yannick répond que certaines charges ont besoin d’un accès direct au matériel, et reconnaît que, même quand un cluster sur VM atteint les mêmes performances, certains clients veulent leur Kubernetes sur du physique, par « mindset ». Plutôt honnête de la part de celui qui présente la fonctionnalité.

Reste le stockage. Si vous avez déjà un cluster NCI (Nutanix Cloud Infrastructure), le CSI (le pilote de stockage de Kubernetes) permet de consommer son stockage depuis les nœuds physiques. Sinon, il faudra regarder du côté de CN-AOS…

Le cluster mixte AHV et bare metal

C’est le scénario que Yannick dit recevoir le plus souvent en demande, et je comprends pourquoi : un cluster Kubernetes hautement disponible réclame trois control planes, et dédier trois serveurs physiques à des nœuds qui n’utiliseront jamais toutes leurs ressources coûte cher. Avec NKP 2.19, vous déployez votre cluster sur AHV, control planes et workers en VM, puis vous lui ajoutez un node pool NKP Metal avec vos machines GPU.
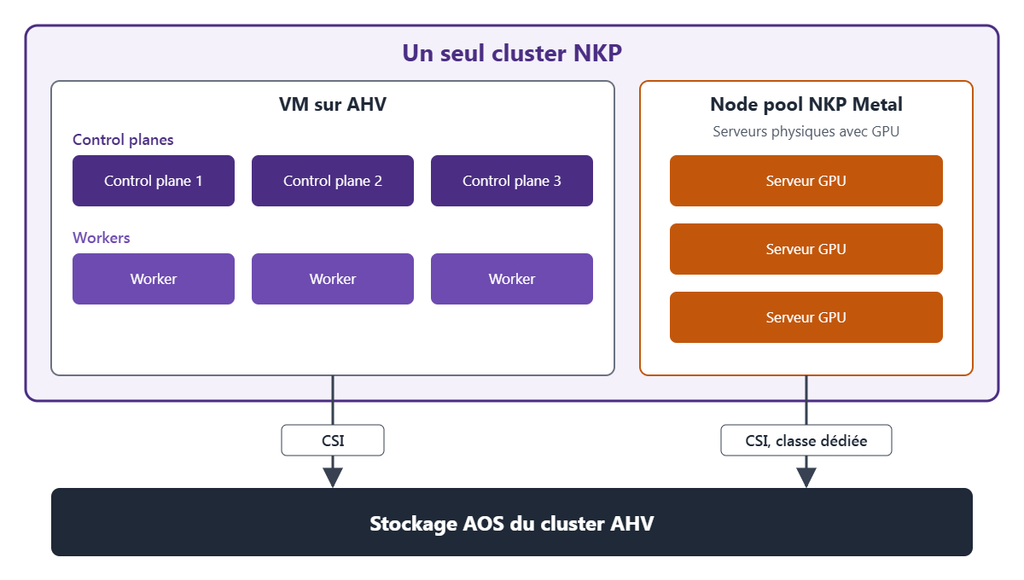
Schéma d'un cluster NKP mixte, avec des nœuds virtualisés sur AHV et un node pool de serveurs physiques équipés de GPU

Le verrou était côté stockage. En mode bare metal, le CSI perdait la gestion de la topologie et les volumes attachés par l’hyperviseur. Il sait désormais quels nœuds peuvent les utiliser, avec une classe de stockage distincte pour le bare metal.

Un NTC a reconnu que ce manque avait fait renoncer son équipe à NKP deux ans plus tôt. « Huge improvement », a-t-il lâché, et un autre a résumé la salle d’un mot : « Sold. »

Ce que NKP 2.19 change au quotidien

NKP Metal occupe le devant de la scène, pourtant ces évolutions-là toucheront bien plus de monde.

  • Le registry unifié : en environnement connecté, les images de conteneurs venaient de plusieurs dépôts. Elles convergent vers un registry Nutanix unique, basé sur Docker Hub, avec un token créé sur le portail Nutanix pour déployer le management cluster. Les sites déconnectés et les registries miroirs ne sont pas concernés. Comme la démarche vise toute l’entreprise, un NTC fatigué de négocier ses listes d’URL avec les équipes sécurité a glissé un « you just made my day » bien senti.
  • Projects 2.0 : avec Prism Central 7.6, les VM, les volumes persistants et les images d’OS d’un cluster sont rattachés au même projet, alors qu’il fallait auparavant donner accès à chaque ressource séparément. Le RBAC (la gestion des droits par rôle) s’en trouve nettement simplifié, en particulier pour les fournisseurs de services.
  • L’AHV VM Operator : il décrit une VM, Windows comprise, comme une ressource Kubernetes, et peut l’exposer via un service LoadBalancer ou ClusterIP. À la différence d’OpenShift Virtualization, la VM ne tourne pas dans le cluster Kubernetes : elle est déployée sur AHV.

Les mises à jour, jusqu’ici en CLI, se font désormais depuis l’interface ou de façon déclarative en GitOps, avec des contrôles avant et après l’opération. L’ordre reste imposé par la documentation NKP 2.19 (« Upgrade Nutanix Kubernetes Platform ») : le management cluster d’abord, avec Kommander puis la CLI NKP, et les workload clusters ensuite, un par un, en commençant par leurs applications de plateforme. Sur un cluster géré en GitOps, les control planes sont renouvelés avant les workers.

CN-AOS, le stockage AOS sans hyperviseur

Divyansh, qui dirige le product management du stockage chez Nutanix, part de la question que pose NKP Metal : sans hyperviseur, d’où vient le stockage ?

Sa réponse s’appelle CN-AOS (Cloud Native AOS). Le moteur de stockage d’AOS tourne dans des pods Kubernetes, l’équivalent cloud native des CVM (les VM de contrôle d’un cluster Nutanix), et s’appuie sur les disques locaux des nœuds. On y retrouve le thin provisioning, la data locality, le RF2 (deux copies de chaque donnée) et la compression inline, la déduplication et l’erasure coding étant annoncés pour plus tard. Le CSI expose deux modes d’accès, RWO (un seul nœud en écriture) et RWX (plusieurs nœuds), ce qui permet de servir un partage de fichiers ou des home directories sans acheter une solution de stockage de plus.

CN-AOS a d’abord été lancé sur AWS, sur des instances EC2 orchestrées par EKS. Divyansh le dit disponible avec NKP 2.19, annonce une expérience améliorée pour NKP 2.21 et n’exclut pas de l’ouvrir à OpenShift sur bare metal.

La documentation est plus prudente : le guide CN-AOS 1.0.0 du 17 juin 2026, antérieur à NKP 2.19, ne traite que d’EKS. Il donne tout de même un ordre d’idée à vérifier sur NKP Metal : de 3 à 15 nœuds, et jusqu’à 48 GiB de mémoire et 16 vCPU réservés par nœud. Sur un serveur acheté pour ses ressources, ça se dimensionne.

NDK pour protéger les applications
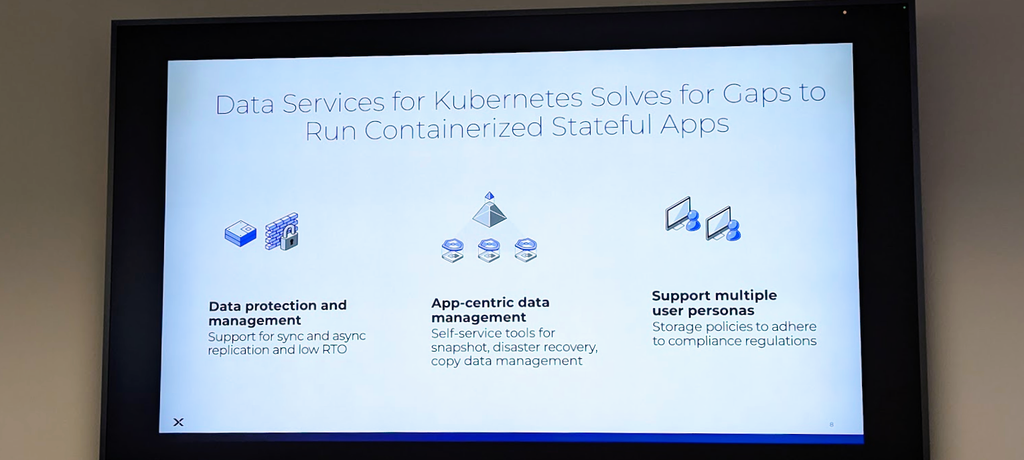
Slide présentant les services de données de NDK pour faire tourner des applications conteneurisées avec état

Divyansh voit dans NDK (Nutanix Data Services for Kubernetes) la pièce qui permet de sortir des applications sans état, avec des snapshots et une réplication synchrone ou asynchrone que les équipes applicatives pilotent elles-mêmes. Il veut couvrir NKP sur AHV et NKP Metal avec CN-AOS, puis à terme le management cluster, dont la sauvegarde part aujourd’hui vers S3 avec Velero, sans les données applicatives.

Les notes de version de NDK 2.3, datées du 21 septembre et donc antérieures à NKP 2.19, invitent à attendre la prochaine matrice de compatibilité avant de s’emballer. Elles apportent une interface web, incluse dans le chart Helm, et demandent au minimum NKP 2.18.0, AOS 7.5.1 et Prism Central 7.5.1, mais ni NKP Metal ni CN-AOS n’y figurent.

Trois limites sont à garder en tête :

  • La cohérence : elle n’est pas garantie entre les partages de fichiers et les volumes bloc d’une même application (ENG-823426).
  • La réplication : elle se fait d’un cluster vers un seul autre (ENG-756494), avec la même distribution Kubernetes des deux côtés.
  • CN-RWX : il n’apparaît que dans une anomalie (ENG-923368), des pods bloqués en Terminating après une panne de stockage à l’échelle d’un site.

Côté CN-AOS, le guide limite le DR (la reprise après sinistre) sur EKS à l’asynchrone, avec un RPO (la perte de données maximale admise) d’une heure ou plus. On reste loin de la réplication synchrone annoncée pour NDK en général.

Mon avis sur NKP Metal et CN-AOS

Je n’ai rien testé, donc je m’en tiens aux cas d’usage qui me paraissent les plus évidents : les infrastructures d’IA denses en GPU, les environnements edge déconnectés ou en succursales, et les DSI qui cherchent à unifier leur gestion. Sur ces trois terrains, retirer l’hyperviseur a du sens, et le cluster mixte me semble être la porte d’entrée la plus raisonnable.

Ces sessions m’ont surtout donné envie de vraiment trouver le temps de m’y mettre, avant que NKP ne glisse sur ma roadmap 2028.

Yannick a aussi présenté la suite, mais elle est sous NDA : vous n’en saurez donc pas plus… Si vous voulez d’autres regards sur cette journée, je vous invite à lire les comptes rendus de Jeroen Tielen et de Patrick Damen.

Et vous, envisagez-vous de faire tourner Kubernetes sans hyperviseur ?
Read More

Lundi 26 octobre, 8 heures, devant le panneau du 1740 Technology Drive à San Jose : c’est ici, au siège de Nutanix, que démarre le Nutanix Tech Connect 2026, et j’y arrive avec sur le dos le sweat « Unstoppable » qui m’a accompagné pendant tout le voyage, un nom qui a pris tout son sens ce week-end. Si vous avez manqué l’épisode précédent, je vous raconte les 53 heures qu’il m’a fallu pour rejoindre la Californie dans cet article.

Petite consolation après le petit déjeuner : Drew Plaster me remet la commande que j’avais passée sur le Nutanix Store et fait livrer chez lui pour éviter des frais de port excessifs. Dedans, un t-shirt NKP qui tombe à pic vu le programme du jour, une couverture parce que l’hiver vient, une laisse pour le chien, et un cadeau personnel glissé par Drew, un sabre laser aux couleurs de Nutanix…

Sabre laser blanc et chromé au logo Nutanix posé sur un t-shirt NKP et un sweat orange

Nous sommes 25 NTC, venus de 6 pays, et je suis le seul Français du programme NTC. C’est ma deuxième participation après celle de 2024, et cette première journée tourne presque entièrement autour de NKP (Nutanix Kubernetes Platform), qui occupe quatre des sept sessions.

Ma pomme devant le panneau d'entrée du siège de Nutanix à San Jose

Une partie de ce qui nous a été présenté est sous NDA : je vous partage ici tout ce que j’ai le droit de dire, et les slides de roadmap resteront dans mon téléphone.

Bienvenue au Nutanix Tech Connect 2026 !

Avant d’entrer, passage obligé par la séance photo devant le panneau, puis à l’intérieur devant le grand X lumineux du hall, chacun prenant la pose à tour de rôle.

Le Nutanix Technology Champion français posant devant le grand X lumineux du hall du siège de Nutanix

À 8h20, le temps d’attraper un café et un petit gâteau, Angelo Luciani nous souhaite la bienvenue au Nutanix Tech Connect 2026. Premier conseil de la journée : se former à Kubernetes, avec en ligne de mire la KCNA (Kubernetes and Cloud Native Associate), la certification d’entrée de gamme de la CNCF. C’est noté, mais c’est pour moi un objectif à long terme : avant de viser un examen, je dois d’abord me plonger sérieusement dans NKP et dans Kubernetes, et la suite de la journée allait m’y aider.

Angelo nous présente ensuite le proof of concept d’un portail dédié au programme NTC sur lequel il travaille, et nous demande nos retours pour améliorer ce premier jet. Je l’ai trouvé excellent, et nous ne nous sommes pas privés de lui faire nos remarques sur place.

Selfie de Julien Dumur avec Jeroen Tielen et Kim Mount, d'autres NTC, dans la salle du Tech Connect 2026

L’avenir du programme est revenu sur la table à 12h30, avec un workshop intitulé « The next decade of NTC starts here », où nous avons planché en groupes sur ce que devrait être le programme en 2036. Je ne peux pas vous en dire plus, le contenu de nos échanges reste entre NTC pour le moment.

Thomas Cornely, un Français dans la Silicon Valley

À 9h00, Thomas Cornely, EVP Product Management, nous rejoint pour son mot de bienvenue, et je découvre que je ne suis pas tout à fait le seul Français de la salle : il est originaire de France et installé dans la Silicon Valley depuis 25 ou 26 ans. Il déroule son parcours avec une franchise qui m’a plu : des débuts chez France Télécom R&D, puis la Silicon Valley, où il passe par Symantec sur la gamme Veritas Storage Foundation, Greenplum, Violin Memory, cinq ans comme Chief Product Officer chez Nexenta et quelques mois chez Rubrik, avant d’arriver chez Nutanix au printemps 2020, au tout début du COVID, avec pour mission de remettre de la cohérence dans un portfolio devenu très fragmenté. Lui-même se décrit comme « le janitor » (l’homme de ménage), celui qu’on appelle pour remettre de l’ordre. Je trouve ce parcours très inspirant et franchement impressionnant.

Thomas Cornely, EVP Product Management de Nutanix, s'adressant aux NTC au Tech Connect 2026

Son équipe compte environ 150 personnes, dont une cinquantaine de solutions engineers très techniques qui travaillent avec les plus gros clients et produisent les NVD (Nutanix Validated Designs). Chaque NVD passe par de vrais tests terrain, pendant lesquels l’équipe « casse beaucoup de choses » avant que l’ingénierie ne comble les manques. C’est pour ça que certains NVD sortent en neuf mois et d’autres en deux ans.

Sur le portfolio, il insiste sur la façon dont les briques s’emboîtent. Flow est désormais traité au même rang qu’AHV, sous la même équipe d’ingénierie. NDB (Nutanix Database Service) a toute sa place dans un monde où des agents devront travailler sur des clones de bases plutôt que sur la production. Quant à NKP, c’est un succès après plusieurs tentatives internes qui avaient tourné court. Le rachat de D2iQ, qu’il a lui-même piloté et qu’il qualifie de « presque un coup de chance », a apporté l’équipe et la culture open source qui manquaient, avec un parti pris assumé : un Kubernetes pensé pour les opérateurs, là où OpenShift s’adresse d’abord aux développeurs.

Plus surprenant, il raconte qu’en décembre dernier, juste avant de rentrer en France pour les fêtes, il a décidé de « faire exploser » toute la roadmap 2026 pour investir massivement dans l’infrastructure dédiée à l’IA. Et les VM ne disparaissent pas du tableau : un agent autonome qui tourne pendant des jours a besoin d’accéder à des données avec les bonnes permissions et doit rester disponible, exactement comme un poste de travail virtuel, un terrain que Nutanix connaît par cœur.

Place aux questions. John Heim demande si le support du stockage externe, annoncé au .NEXT 2025 avec Dell et Pure Storage, était prévu de longue date ou imposé par le marché. Réponse de celui qui a porté cette décision : l’opportunité. En augmentant massivement ses prix après le rachat de VMware, Broadcom a créé des clients qui apprécient toujours la technologie mais n’aiment plus l’éditeur. Et pour Thomas, l’hyperconvergence a toujours été un moyen d’arriver à la simplicité : si Nutanix peut offrir la même chose avec une baie Pure Storage ou des nœuds compute-only bourrés de GPU, tant mieux.

René van den Bedem l’interroge ensuite sur les dix ans à venir, au-delà de l’IA. Dans un secteur où tout change tous les six mois, dix ans représentent une éternité, et la suite passera autant par l’IA intégrée aux produits que par celle que Nutanix utilise en interne pour ses propres équipes : un terrain de jeu immense, en somme…

Petite anecdote pour finir : Thomas ne supporte pas les documents de dix pages qui répètent cinquante fois la même chose, et il impose une règle de deux pages maximum. Je vais donc essayer de rester concis pour la suite de cet article…

NKP et l’IA : Kubernetes taillé pour les GPU

À 9h40, Sonali Mishra, Principal Product Manager NKP, prend le relais. Elle vient de D2iQ, où elle a lancé la toute première version du produit, à l’époque DKP 2.0, et elle commence par une slide qui a fait son petit effet dans la salle : sur l’infrastructure Nutanix, NKP a dépassé OpenShift et Rancher, aussi bien en nombre de clients qu’en nombre de cœurs déployés.

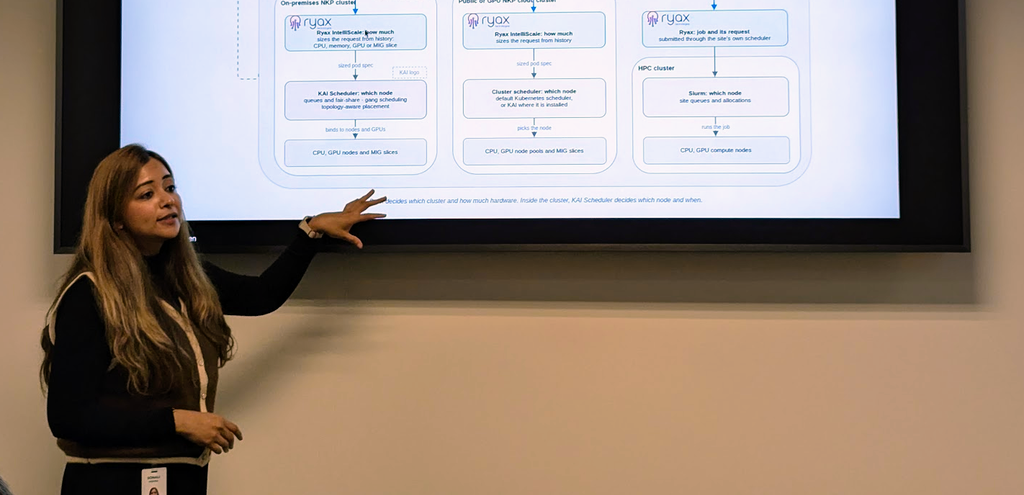
Sonali Mishra, Principal Product Manager NKP, présentant NKP aux NTC

Son sujet du jour, c’est l’IA, et son point de départ est simple : près de 99 % des workloads d’IA sont conteneurisés, donc ils finiront sur Kubernetes, et de plus en plus souvent directement sur des serveurs physiques équipés de GPU. Pour préparer NKP à ces workloads, Nutanix a ouvert trois chantiers. Le premier est la certification CNCF AI Conformance, obtenue environ six semaines plus tôt, qui garantit qu’une application d’IA qui tourne sur un Kubernetes vanilla tournera aussi sur NKP. Le référentiel bouge si vite que trois nouvelles exigences obligatoires y sont déjà apparues depuis.

Le deuxième chantier est l’AI Catalog, qui déploie en un clic tout l’outillage dont une équipe MLOps a besoin : les operators GPU NVIDIA et AMD, le KAI Scheduler, Slurm via l’operator Slinky, Kueue, KServe et Envoy Gateway pour l’inférence, Nutanix Enterprise AI, Jupyter, Kubeflow, Milvus et le serveur MCP de NKP. Le KAI Scheduler m’a parlé : là où le scheduler Kubernetes éparpille les workloads sur trois nœuds GPU, lui les empile sur un seul nœud et garde les deux autres libres. Le troisième chantier est le support des GPU AMD au même niveau que NVIDIA, pour laisser le choix aux clients en pleine pénurie de matériel. Intel, en revanche, n’est pas au programme faute de demande.

Sonali nous présente aussi AI Navigator, l’assistant intégré à NKP, entraîné sur huit à neuf ans de cas de support et d’articles KB. Il répond aux questions sur l’état des clusters mais ne prend encore aucune action (les clients n’en voulaient pas jusqu’ici), et il accepte votre propre modèle pour les environnements air-gapped.

Dernière annonce, et pas des moindres pour un lecteur français : Nutanix a racheté Ryax Technologies, une société française. Son produit IntelliScale observe les workloads dans le temps pour corriger les ressources que les développeurs surestiment systématiquement. Couplé au bin packing du KAI Scheduler, les premiers benchmarks annoncent 30 à 40 % d’optimisation.

NKP 2.19 et CN-AOS : rendez-vous dans un article dédié

À 10h50, Yannick Struyf, Principal Product Manager NKP, enchaîne sur les nouveautés de NKP 2.19, sortie la semaine précédente, avec en vedette NKP Metal, du Kubernetes directement sur des serveurs physiques. Divyansh, qui dirige le product management du stockage chez Nutanix, prend la suite à 11h40 pour présenter CN-AOS (Cloud Native AOS), le moteur de stockage d’AOS empaqueté en pods Kubernetes. Ces deux sessions sont trop riches pour tenir en quelques lignes : je leur consacre un article dédié, qui arrive très vite…

Yannick Struyf, Principal Product Manager NKP, présentant les nouveautés de NKP 2.19

NKP Insights : une carte plutôt que neuf cents alertes

Après le déjeuner et le workshop, Sonali revient à 13h15 pour parler de NKP Insights, le composant de sécurité et d’observabilité inclus dans l’édition NKP Ultimate. Les chiffres qu’elle projette posent le décor : 82 % des utilisateurs de conteneurs font tourner Kubernetes en production, contre 66 % en 2023, 89 % des organisations ont subi au moins un incident de sécurité lié aux conteneurs ou à Kubernetes sur les douze derniers mois, et 46 % y ont perdu du chiffre d’affaires ou des clients.

Slide de titre de la session NKP Insights, la sécurité Kubernetes à l'échelle de la flotte

Le problème grossit avec la taille de la flotte : dérive de configuration, API dépréciées qui bloquent les upgrades, certificats qui expirent sans prévenir. Elle cite l’exemple d’un client qui fait tourner NKP sur 60 à 70 navires et doit les mettre à jour tous les six mois. NKP Insights s’appuie sur des briques open source à chaque étape : Harbor et Trivy au build, avec les images durcies issues du partenariat avec RapidFort, Gatekeeper au déploiement, Trivy et Polaris pour les scans en continu, et Falco pour la sécurité à l’exécution, dont la disponibilité générale est prévue en décembre.

La valeur ajoutée, c’est le moteur qui corrèle tous ces signaux sur un graphe et ne remonte qu’une carte par problème, avec la cause et la correction à appliquer. Chaque carte peut ensuite être mise en sourdine, reportée ou résolue. Tout tourne dans le cluster, y compris en air-gapped, avec les bases de vulnérabilités livrées dans les releases, et chaque insight est une Custom Resource soumise au RBAC de NKP.

La démo a fait réagir plusieurs NTC, qui aimeraient voir le reste des produits Nutanix traiter les alertes de la même façon. L’un d’eux a résumé la situation avec un exemple que tout administrateur Nutanix reconnaîtra : un certificat NGT qui expire, et ce sont neuf cents alertes qui tombent…

Topologies NKP : quorum, quorum, quorum !

À 14h15, Yannick revient pour une session sur les topologies de déploiement et la résilience de NKP, avec un parti pris que j’ai beaucoup aimé : partir des pannes plutôt que des fonctionnalités.

Slide de titre de la session sur les topologies de déploiement et la résilience de NKP

Premier cas, la perte du management cluster : aucun impact sur les workloads en cours, mais plus de scaling ni d’upgrade tant qu’il n’est pas revenu. NKP le sauvegarde avec Velero vers un stockage objet compatible S3, Nutanix Objects par exemple, et la restauration consiste à recréer un management cluster vierge puis à y réimporter la sauvegarde, un peu comme PCBR pour Prism Central. Attention, seules les métadonnées sont sauvegardées, pas les applications.

Viennent ensuite les nœuds Kubernetes, et le mot « quorum », qui justifie les trois control planes, est revenu si souvent dans les réponses de la salle que c’est devenu le running gag de l’après-midi. Le piège classique est ailleurs : sans règle de placement, AHV peut poser deux control planes sur le même hôte, et la perte de cet hôte fait tomber le quorum, et avec lui toutes les écritures sur l’API Kubernetes. Et une seule règle d’anti-affinité pour toutes les VM du cluster ne suffit pas, il en faut une pour les control planes et une pour les workers, avec assez d’hôtes derrière.

Sur trois datacenters, NKP sait répartir les control planes entre domaines de panne, mais l’etcd exige une latence inférieure à 5 à 10 ms entre sites et le stockage n’est pas répliqué : le CSI 3.x crée le volume sur le cluster AOS du worker qui l’utilise, et rien de plus. Sur deux datacenters, la recommandation est claire : un cluster Kubernetes par site, un load balancer devant, et NDK pour répliquer les applications avec état.

Yannick a conclu sur la « solution parfaite » qu’un interlocuteur lui avait un jour présentée pour Kubernetes sur deux datacenters : déployer cinq control planes…

Réseautage, réception… et valise

À 15h15, les sessions laissent place aux discussions entre NTC, puis à la réception à partir de 17h, l’occasion de prolonger les échanges de la journée autour d’une bière. Une réception durant laquelle Angelo, notre hôte, nous a livré une performance de haut vol au karaoké !

Deux NTC trinquant avec une bière lors de la réception du Tech Connect 2026

Et en rentrant à l’hôtel, une bonne surprise m’attendait : ma valise, arrivée de Francfort avec deux étiquettes « RUSH » collées à la hâte, une par vol Lufthansa.

Étiquettes de bagage marquées RUSH sur la poignée d'une valise

Demain, l’IA agentique sera au cœur du programme, et j’aurai enfin des vêtements de rechange…

Read More