Nutanix Technology Champion - Nutanix Solution Architect

Julien DUMUR
Infrastructure in a Nutshell

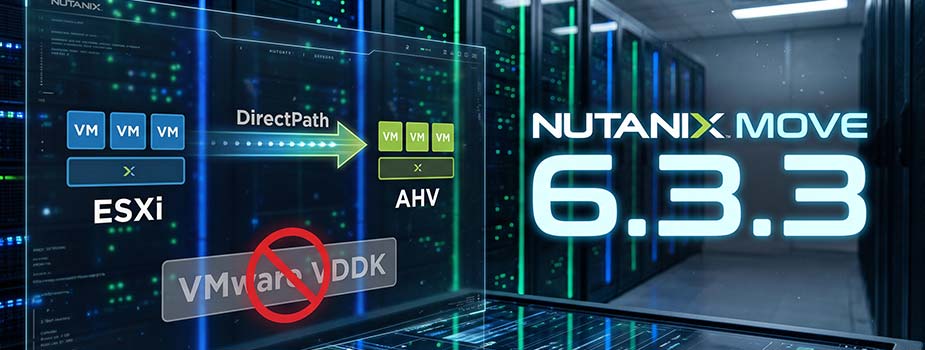
Nutanix Move 6.3.3 est sorti ce 12 octobre 2026 et apporte une nouvelle méthode de migration, DirectPath, qui permet de migrer des machines virtuelles d’ESXi vers AHV sans le VDDK de VMware. Dans cet article, je passe en revue ce que contiennent les release notes, y compris ce qu’il vaut mieux savoir avant de télécharger l’appliance.

DirectPath : la migration ESXi vers AHV sans VDDK

Le VDDK (Virtual Disk Development Kit) est la bibliothèque de VMware sur laquelle Move s’appuyait pour lire les disques des machines virtuelles hébergées sur ESXi. Depuis Move 5.30, il fallait aller la télécharger soi-même chez Broadcom avant de la téléverser dans l’appliance, ce que j’avais détaillé dans mon article Nutanix Move 5.30+ : récupérer les fichiers VMware VDDK !.

Ce téléchargement, je l’ai vu se refermer par étapes : d’abord libre moyennant une inscription, puis réservé aux clients et aux partenaires, puis aux seuls partenaires, et enfin complètement bloqué. Migrer hors de VMware ne faisait visiblement pas partie des usages que Broadcom souhaitait encourager.

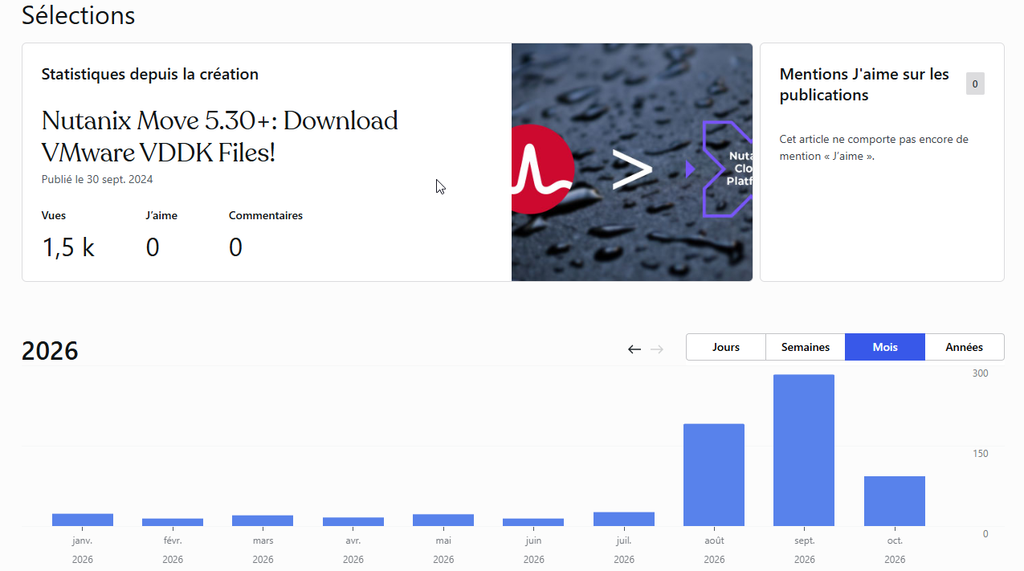
Les statistiques de la version anglaise de cet article en gardent la trace : elle tournait à 19 vues par mois en moyenne de janvier à juillet 2026, elle en a fait 191 en août puis 283 en septembre, son record depuis sa publication.
Avec Move 6.3.3, le problème disparaît. Les release notes décrivent DirectPath comme une méthode qui transfère directement les données des disques d’une VM depuis ESXi vers AHV, « eliminating the requirement for VMware Virtual Disk Development Kit (VDDK) ». Elles n’en disent pas plus sur son fonctionnement, et comme je n’ai pas encore déployé cette version dans mon lab, je ne vais pas l’inventer.

Move 6.3.3 ne se met pas à jour, il se redéploie

Les release notes le signalent dans un encadré « Important » : « Nutanix Move 6.3.3 supports new deployments only. You cannot upgrade to or from this version. » Votre appliance actuelle ne passera donc pas en 6.3.3, et le « to or from » indique que celle que vous déploierez aujourd’hui ne se mettra pas davantage à jour vers la version suivante.

Sur le portail Nutanix, la page de téléchargement de la 6.3.3 ne propose à ce jour qu’un seul fichier d’appliance, « Move OVA file for ESXi », sans image dédiée à AHV :
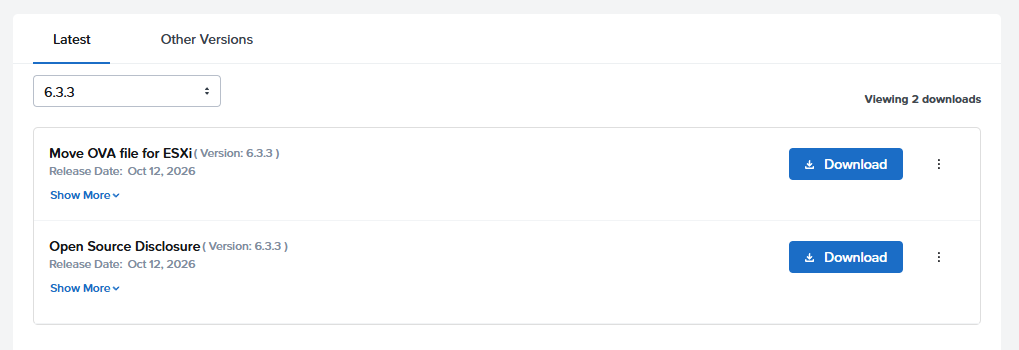
Je n’ai pas encore déployé cet OVA sur un cluster AHV, ma procédure de l’époque (Nutanix Move – Partie 4 : Déploiement de la solution) est donc à prendre avec précaution pour cette version.

Deux nouvelles permissions vCenter

Les migrations depuis ESXi demandent deux privilèges supplémentaires sur le compte vCenter utilisé par Move :

  • Provisioning: Allow virtual machine download
  • Cryptographic Operations: Direct Access

Les release notes les exigent pour toute migration « with ESXi as source », sans les réserver à DirectPath. Les autres prérequis, je les avais listés dans Nutanix Move – Partie 3 : Prérequis.

Versions supportées par Nutanix Move 6.3.3

  • AOS : 6.10, 7.0, 7.3, 7.5 et 7.6
  • Prism Central : pc.2024.3, pc.7.3, pc.7.5 et pc.7.6
  • Hôtes ESXi : 6.5, 6.7, 7.0 jusqu’à l’Update 3, 8.0, 8.0 Update 1 et 8.0 Update 3
  • vCenter : 6.7, 7.0 jusqu’à l’Update 3, 8.0, 8.0 Update 3 et 9.0

La liste a ses trous : vCenter 9.0 y figure alors qu’ESXi 9.0 n’y est pas, ESXi 8.0 Update 2 est absent côté hôtes, et vCenter 8.0 Update 1 et Update 2 le sont aussi. Je ne sais pas s’il s’agit d’oublis ou de versions non qualifiées.

Les hôtes ESXi en licence gratuite ne sont pas supportés, et la version de VirtIO supportée est la 1.2.5, dont j’avais parlé dans Nutanix AHV : VirtIO v1.2.5 est disponible !.

Les problèmes connus à lire avant de migrer

La liste des problèmes connus est longue, j’en retiens cinq qui touchent directement une migration depuis ESXi :

  • ENG-981753 : en DirectPath, la migration échoue avec le message « Invalid configuration for device ‘0’ » lorsque deux clusters du même datacenter ont des datastores portant le même nom et des contenus différents. Le contournement consiste à renommer les datastores.
  • ENG-992713 : après le cutover de plusieurs VM migrées sans VDDK, l’agent source ne libère pas la mémoire consommée.
  • ENG-983434 : Move marque comme non migrables les VM hébergées sur un datastore partagé monté sur des hôtes ESXi de datacenters différents.
  • ENG-993473 : Move attache 16 disques au maximum pendant les migrations, même si des emplacements restent libres.
  • ENG-992495 : le CPU de la VM Move atteint sa limite pendant la migration.

Il ne me reste plus qu’à déployer cette version dans mon lab pour voir ce que DirectPath donne sur une vraie migration… En attendant, mon guide ultime de migration vers AHV couvre le reste du parcours.
Read More

Depuis que je parle de mes certifications sur ce blog, on me pose régulièrement la même question : « comment est-ce que tu as révisé ? » J’ai fini par y répondre avec autre chose qu’un article, et depuis juillet 2026, ntnx-mastery.com vous permet de préparer une certification Nutanix gratuitement, avec des cours et des questions d’entraînement construits sur les blueprints officiels. Le portail compte déjà 25 utilisateurs, alors que je n’en ai encore parlé nulle part.

Page d'accueil de ntnx-mastery.com, portail gratuit pour préparer les certifications Nutanix

Pourquoi un portail pour préparer les certifications Nutanix

En 2023, dans Bien préparer ses certifications Nutanix (mais pas que), je donnais ma méthode en dix points : décortiquer le blueprint, prendre des notes, s’entraîner sur des quiz, passer des examens blancs, repérer ses points faibles… La méthode tenait, mais c’était ensuite à chacun d’aller chercher ses ressources, entre Nutanix University, la documentation officielle et ce qu’il trouvait ailleurs pour s’entraîner.

J’ai donc voulu rassembler au même endroit les cours, les ressources et l’organisation des révisions, et j’ai développé le portail seul avec Claude Code. Le site n’a rien d’officiel : c’est un projet personnel, sans lien avec Nutanix.

La génération du contenu est assistée par IA elle aussi : pour chaque certification, l’IA s’appuie sur toute la documentation associée au blueprint, puis je fais une vérification rapide des cours et des questions produits.

Cours et examens blancs sur Nutanix Mastery

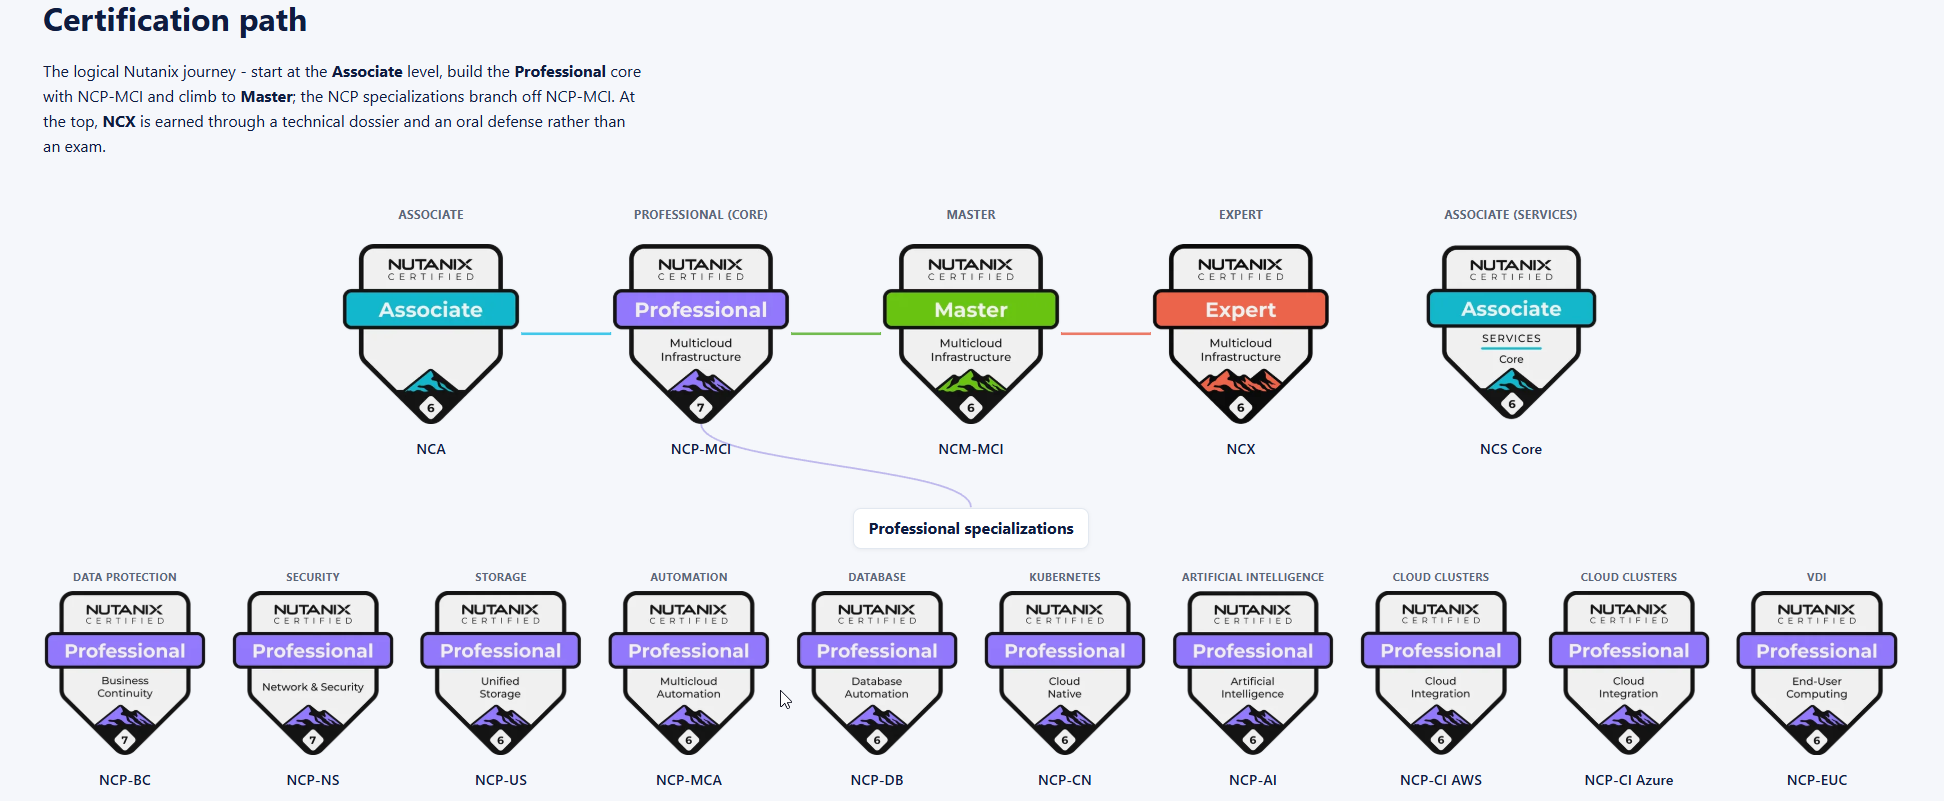
Sept certifications sont disponibles aujourd’hui : la NCA (Nutanix Certified Associate, le premier niveau) et six NCP (Nutanix Certified Professional), à savoir NCP-MCI, NCP-BC, NCP-NS, NCP-US, NCP-MCA et NCP-DB. Chacune a son cours, découpé en chapitres qui suivent les objectifs du blueprint un par un, avec les liens vers la documentation officielle : pour NCP-DB, par exemple, 4 sections et 18 objectifs donnent 18 chapitres. Au total, le portail compte 96 chapitres et 1800 questions d’entraînement.

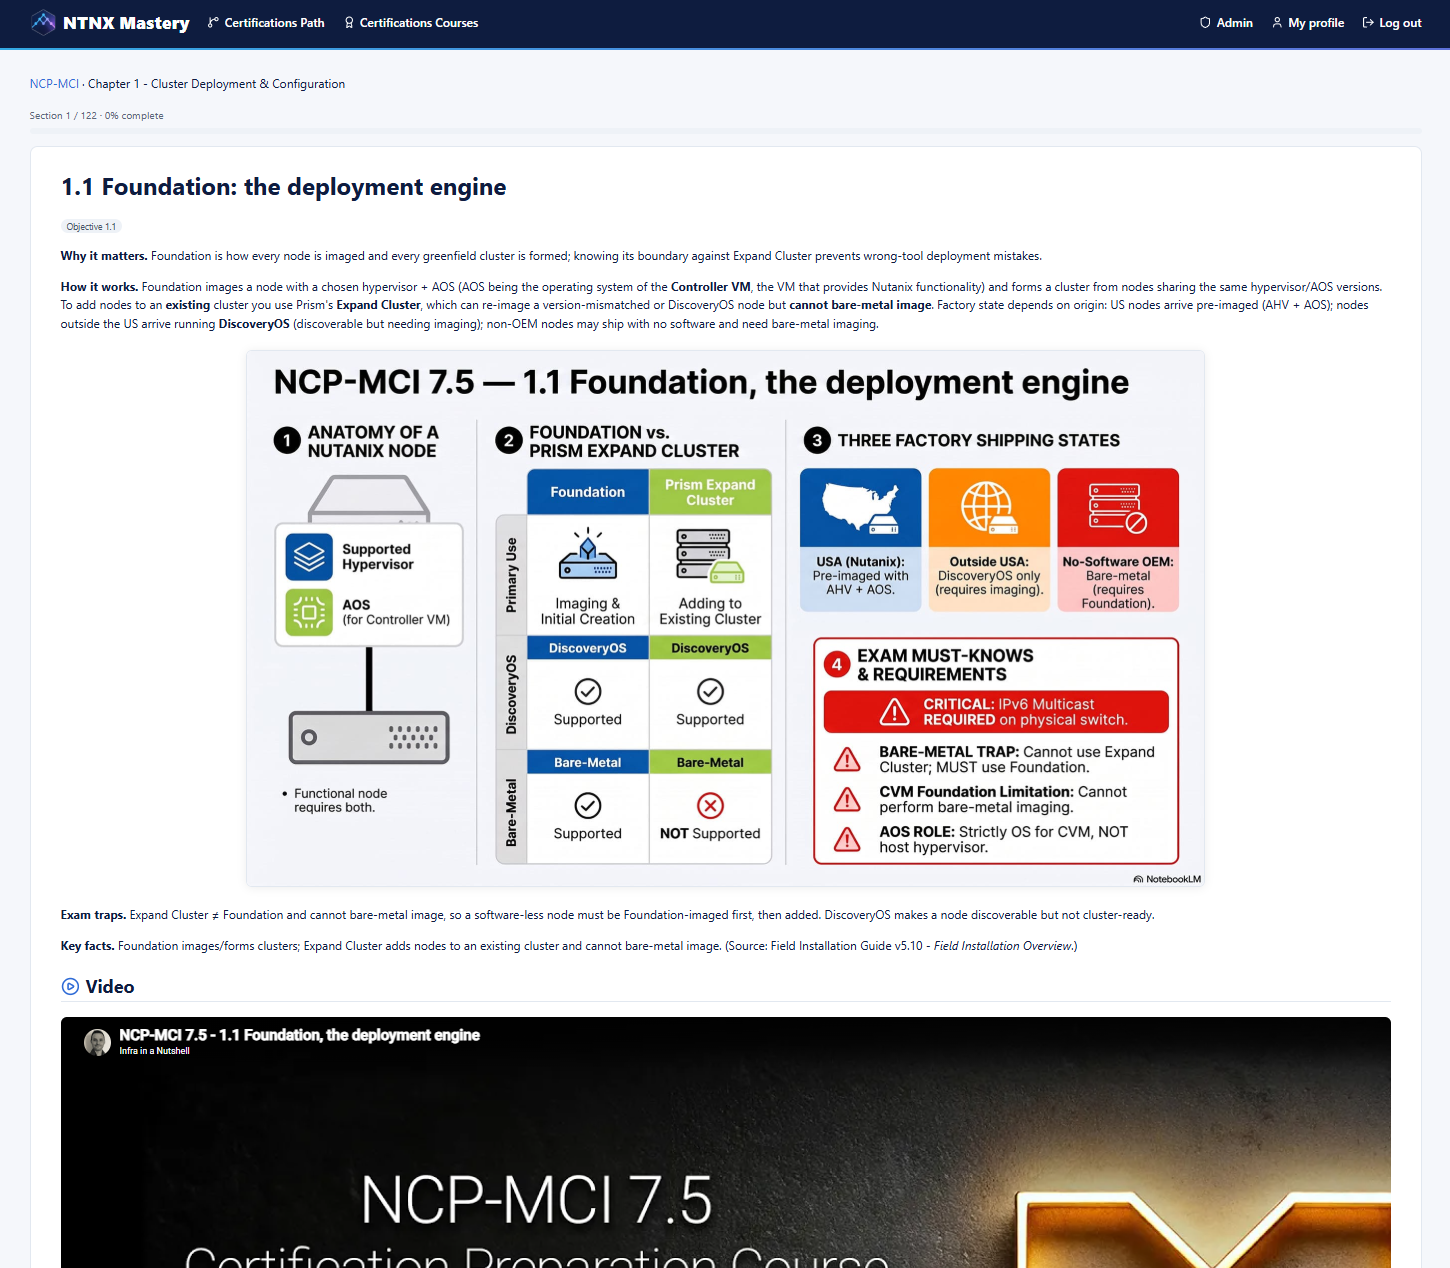
Chaque chapitre suit la même trame : pourquoi l’objectif compte, comment ça fonctionne, les pièges de l’examen et les valeurs voisines qui induisent en erreur, puis les chiffres et les limites à retenir. Quand une information ne peut pas être vérifiée dans la documentation, le cours le signale au lieu de l’inventer, ce qui n’est pas un détail avec un contenu généré par IA.

Parcours des certifications Nutanix sur Nutanix Mastery, de l'Associate à l'Expert

Chapitre 1.1 Foundation du cours NCP-MCI 7.5 sur Nutanix Mastery

Pour s’entraîner, deux modes :

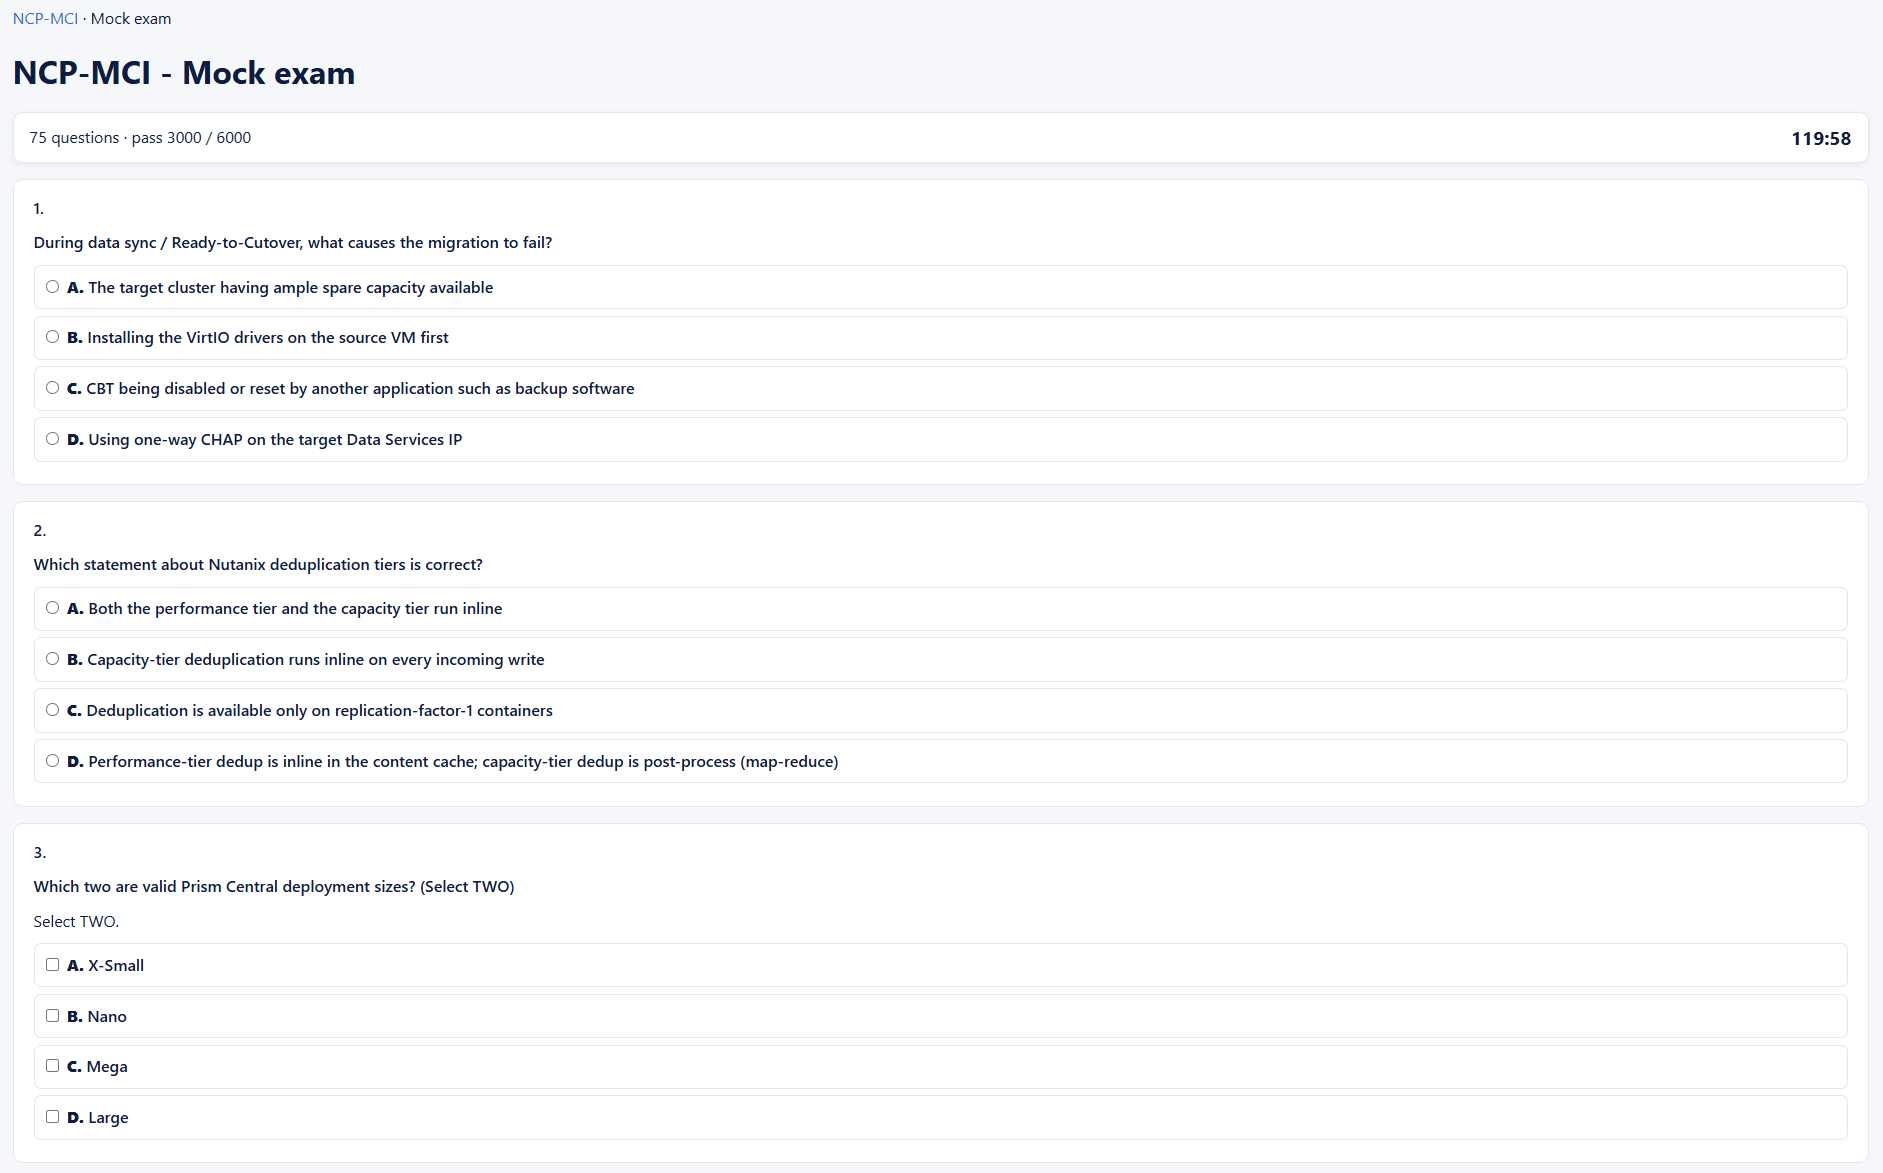
  • Examen blanc : chronométré, avec des questions réparties selon le blueprint, pour se mettre dans les conditions de l’examen.
  • Questions aléatoires : sans limite, pour réviser au fil de l’eau.

Dans la mesure du possible, chaque réponse est accompagnée d’une explication tirée de la documentation officielle, parce qu’une bonne réponse trouvée au hasard n’apprend rien.

Examen blanc NCP-MCI chronométré sur Nutanix Mastery, 75 questions

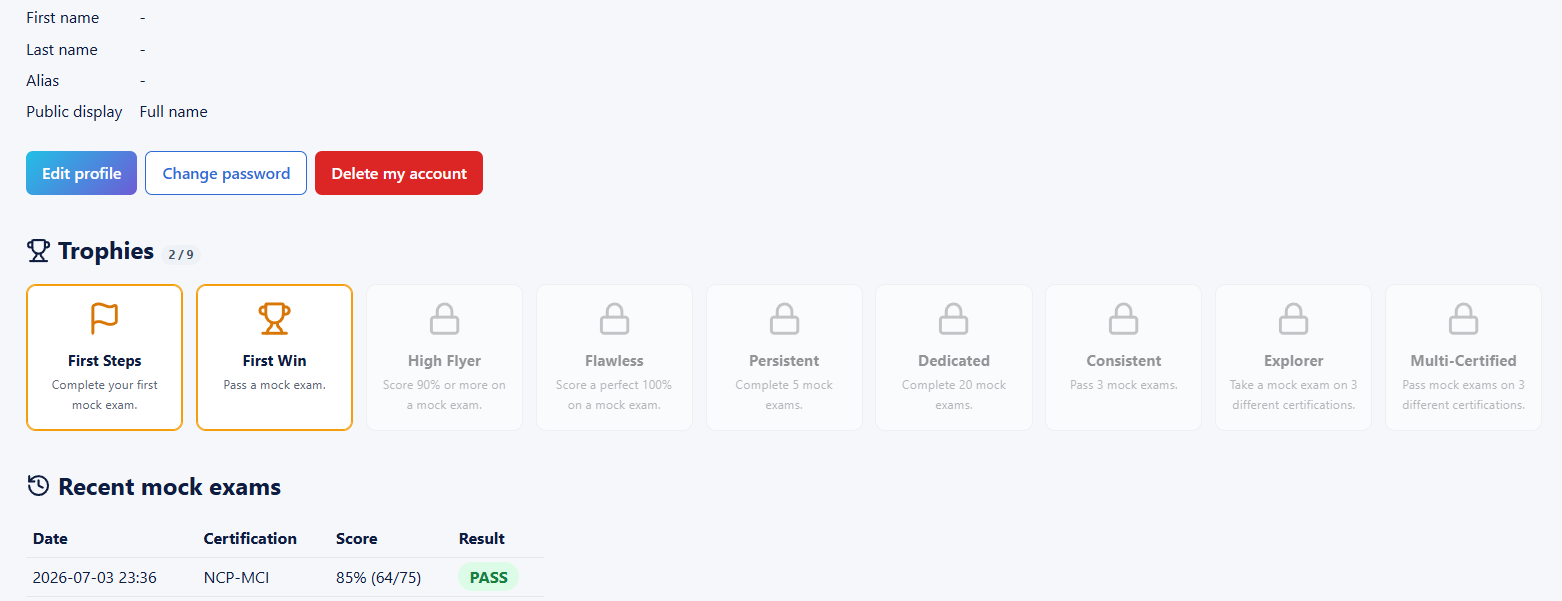
Chaque cours affiche votre avancement, votre profil garde l’historique de vos examens blancs, et 9 trophées (d’autres à venir lors d’une future refonte du système de trophées) sont à débloquer pour ceux qui aiment ce genre de carotte. Un bouton permet de signaler une erreur sur une question, et vous pouvez supprimer votre compte quand vous le souhaitez.

Trophées et historique des examens blancs sur Nutanix Mastery

Le tout est gratuit et le restera : pas de publicité, pas d’abonnement, aucune donnée revendue. En 2024, je vous expliquais comment passer votre certification Nutanix NCA / NCP gratuitement, et vous avez maintenant de quoi la préparer sans rien payer non plus.

Le portail est en anglais uniquement, et c’est voulu : les examens se passent en anglais, autant s’habituer dès les révisions aux termes et aux formulations que vous retrouverez le jour J.

Vous n’y trouverez pas de questions d’examen. Je ne reproduis pas celles que j’ai eues en passant mes certifications, et ce n’est pas le but : les questions couvrent l’ensemble du blueprint et visent les subtilités qui font hésiter entre deux réponses. Si vous cherchez des dumps, vous êtes au mauvais endroit…

Un premier mois de juillet agité

Les cours sont arrivés presque un par jour début juillet : NCP-BC le 8, NCP-NS le 9, NCP-US le 10, NCP-MCA le 14 et NCP-DB le 16. Et les premières erreurs n’ont pas tardé.

La plus bête concernait les questions à réponses multiples : sur certaines d’entre elles, l’énoncé annonçait trois réponses alors que la consigne affichée au-dessus des choix disait « choose 2 ». Malheur ! Impossible de répondre juste à une question qui se contredit elle-même. C’est Guillaume Mesplin, un de mes collègues chez Inetum, qui me l’a signalé, et je l’ai corrigé avec Claude Code. Autre reprise, la banque NCP-US a été refaite le 11 juillet, au lendemain de sa sortie, pour que chaque réponse porte son explication.

Et puis Nutanix a fait passer ses certifications de la 6.10 à la 7.5, juste après la mise en ligne. NCP-DB, publié le 16 juillet sur NDB 2.6 et AOS 6.10, a dû être reconstruit sur le blueprint 7.5, c’est-à-dire NDB 2.10 et Prism Central pc.7.5 : la nouvelle version est en ligne depuis le 5 août, vingt jours plus tard, toujours avec 18 chapitres et 300 questions. Aujourd’hui, NCA, NCP-MCI, NCP-BC, NCP-NS et NCP-DB sont en 7.5 sur le portail, tandis que NCP-US et NCP-MCA sont encore en 6.10.

Ce ne sera pas la dernière bascule. Je vous annonçais déjà en 2024 la sortie de NCA 6.10 et NCP-MCI 6.10, et à chaque nouvelle version, le portail devra suivre.

La suite du portail

Côté contenu, NCP-MCI a déjà ses infographies et ses vidéos, publiées sur ma chaîne YouTube Infra in a Nutshell. Celles de NCP-BC sont en cours de génération, et les autres cours suivront. Sept certifications attendent encore le leur : NCP-CN, NCP-AI, NCP-CI AWS, NCP-CI Azure, NCP-EUC, NCM-MCI et NCS Core.

Si le portail vous a servi et que vous voulez m’encourager à continuer, ou soutenir le blog au passage, j’ai une page Ko-fi.

Et si vous tombez sur une question douteuse, le bouton de signalement est là pour ça, Guillaume a montré la voie… Dites-moi aussi en commentaire quelle certification vous aimeriez voir arriver en priorité !

Bonnes révisions, et à bientôt sur ntnx-mastery.com…

Read More
Nutanix AOS 7.6, AHV 11.2 et PC 7.6 : image d'en-tête de l'article

La nouveauté qui m’a fait le plus plaisir en passant nos clusters de production et mon homelab sur Nutanix AOS 7.6 tient en deux touches de clavier : le copier-coller fonctionne enfin dans la console des machines virtuelles. Elle est pourtant loin d’être la plus structurante de cette version, qui touche surtout à l’accès SSH aux CVM et fait de Prism Central 7.6 une version nettement plus stable que ne l’étaient 7.3 et 7.5 à leur sortie.

Nous sommes partis d’AOS 7.5.1.8 et AHV 11.0.1.8 pour arriver en AOS 7.6.0.6, AHV 11.2.0.2 et Prism Central pc.7.6.0.6, sur plusieurs clusters de production hébergés chez OVHcloud et sur le nœud Supermicro 5019D-FN8TP de mon homelab (8 cœurs, 128 Go de RAM, 2 To bruts).

Pour ce nœud, pas de Foundation sur du matériel non supporté comme je l’avais fait l’an dernier : je suis passé par Nutanix CE. La version précédente, je l’avais présentée dans mon article sur AOS 7.5 et AHV 11.0.

Mise à jour vers AOS 7.6.0.6 : ordre et déroulé

J’ai suivi l’ordre recommandé par Nutanix, que je détaille dans mon article sur LCM : Prism Central d’abord, puis AOS, puis AHV. Sur les clusters de production, tout est passé par LCM avec les versions qu’il proposait ce jour-là, et je n’ai rien chronométré : je lance, et je laisse vivre sa vie.

Sur le homelab, j’ai dû télécharger les fichiers puis les téléverser sur le cluster pour pouvoir lancer la mise à jour, sur le même principe que pour Prism Central 2024.2.

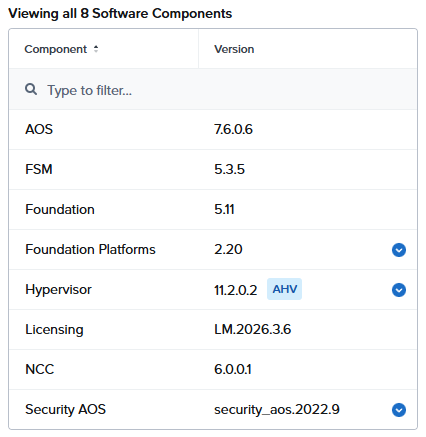
Après la mise à jour, l’inventaire LCM affiche les versions suivantes :

Inventaire LCM affichant AOS 7.6.0.6, AHV 11.2.0.2 et NCC 6.0.0.1 après la mise à jour

Prendre la 7.6.0.6 proposée par LCM plutôt que la 7.6 initiale n’est pas anodin. Ce correctif règle deux blocages connus de la 7.6 : une mise à jour d’AOS qui reste figée sans progresser (KB-22340), et un hôte coincé en « EnteringMaintenance » pendant le passage à AHV 11.2, à cause du service Narsil qui redémarre en boucle. Côté Prism Central, pc.7.6.0.6 corrige aussi l’impossibilité de se connecter à l’interface pendant une mise à jour depuis pc.7.3 ou une version plus récente.

L’alerte « Inconsistent Virtual Switch » après la mise à jour

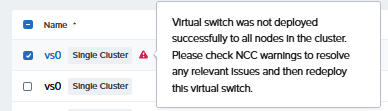
Seul vrai accroc de l’opération : sur deux ou trois de nos clusters, Prism a remonté une alerte « Inconsistent Virtual Switch » une fois la mise à jour terminée. Nutanix la documente comme un problème connu d’AOS 7.6, toujours présent en 7.6.0.6 : le VLAN configuré sur le port du bridge de l’hôte AHV ne correspond plus à celui qu’AOS a enregistré pour le virtual switch (KB-22397).

Le virtual switch vs0 signalé en erreur après la mise à jour vers AOS 7.6.0.6

La même alerte figure aussi dans la liste des problèmes corrigés par la 7.6, pour une autre cause, un écart de MTU entre le bridge br0 des hôtes et le virtual switch. Une variante disparaît, une autre arrive. Nous les avons corrigées.

Prism Central 7.6, enfin stable

Chez nous, en production comme sur le homelab, pc.7.6.0.6 est bien moins buggé que ne l’étaient les premières versions de 7.3 et 7.5. Deux points méritent tout de même d’être vérifiés avant de lancer la mise à jour.

Le premier : pc.7.6 range automatiquement toutes les entités existantes qui n’ont pas de projet dans un projet système, le « Default Project », et cette migration ne permet aucun retour arrière. Le second : Nutanix Kubernetes Engine n’est pas compatible avec pc.7.6, il faut avoir migré ses charges vers NKP avant de mettre à jour. Bonne nouvelle en revanche : le verrouillage du compte admin local toutes les dix minutes signalé en pc.7.6 (KB-22348) n’apparaît plus dans les problèmes connus de pc.7.6.0.6.

Le copier-coller dans la console des VM

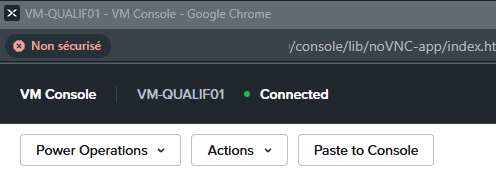
C’est clairement ma nouveauté préférée ! Coller un mot de passe complexe ou une clé de licence dans la console d’une machine virtuelle, au lieu de le retaper caractère par caractère, fonctionne maintenant depuis la console lancée par Prism Central :

Bouton "Paste to Console" dans la console d'une VM AHV 11.2

Il faut AHV 11.2 et pc.7.6 : un cluster resté en AHV 11.0 derrière un Prism Central à jour n’en profite pas. Au passage, l’onglet « Console » des VM est déprécié dans Prism Central, on passe par l’action « Launch Console ».

Secure Access et la fin du SSH direct

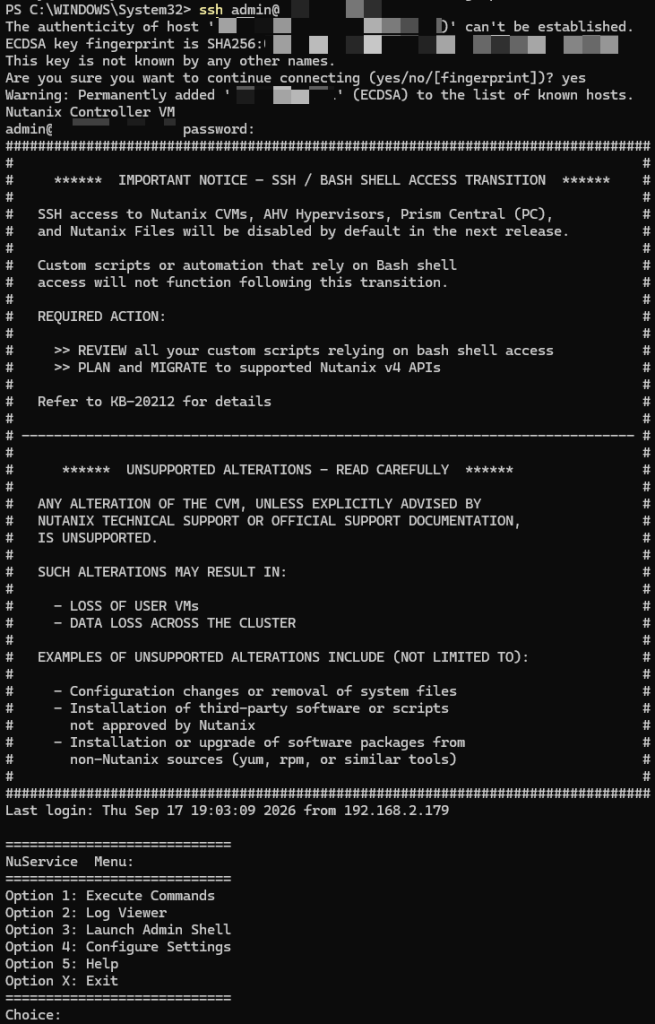
Avec Secure Access, l’utilisateur admin qui se connecte en SSH à une CVM n’arrive plus sur un bash : il atterrit dans le NuService Menu, un shell restreint qui permet de lancer des commandes autorisées sur la CVM ou l’hôte AHV, de consulter les logs du cluster, d’ouvrir une session bash (admin shell) et de gérer l’authentification LDAP locale. Ça surprend au premier abord, et je n’ai pas encore eu besoin d’y passer la moindre commande.

NuService Menu affiché lors d'une connexion SSH en admin sur une CVM AOS 7.6

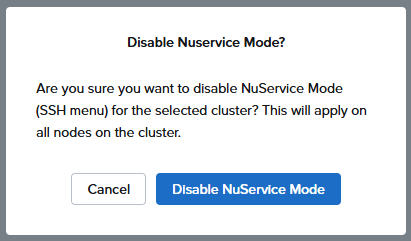
L’utilisateur nutanix garde, lui, une session bash classique. Pour les interventions du support, le « Support-only Login » exige un échange de jeton avec Nutanix et ouvre l’accès bash pour une fenêtre de 72 heures. L’accès SSH externe s’active ou se désactive cluster par cluster depuis Prism Central, via le « NuService Mode », avec confirmation à chaque bascule :

Boîte de dialogue de désactivation du NuService Mode dans Prism Central

Côté hôtes, AHV 11.2 ferme par défaut l’accès SSH externe sur le port 22 : on passe par la CVM pour atteindre l’hôte, et le réglage d’accès SSH externe ne concerne plus que les CVM. Ce que je décrivais dans La fin du SSH sur Nutanix se confirme version après version.

Dernier changement sous le capot : la CVM et la VM Prism Central reposent maintenant sur RHEL 9, alignées sur le guide de durcissement STIG de RHEL 9. Au quotidien, ça ne change pas grand-chose.

Ce que je n’ai pas encore testé

Plusieurs nouveautés importantes de cette version attendent que je les essaie, je me contente donc de les lister :

  • Tolérance aux pannes : nouveau mode 1N/2D (un nœud ou deux disques), et 1N&1D possible au-delà de trois nœuds, avec conversion depuis Prism Central.
  • Extension de cluster : passage d’un cluster AHV de deux à trois nœuds.
  • Migration à chaud entre clusters : d’une version d’AHV plus ancienne vers une plus récente, avec choix du stockage de destination.
  • BIOS UUID : conservé au failover et à la restauration, pour que les logiciels de sauvegarde tiers ne cassent pas leur chaîne.
  • Métriques mémoire : la mémoire récupérée par le ballooning est désormais séparée de la consommation réelle des VM.
  • Capacité par nœud : 307 To en all-flash NVMe contre 185 To auparavant, uniquement pour les nouveaux déploiements démarrés en 7.6. Un cluster mis à jour garde ses limites.

À anticiper : la fin des API legacy

Les API v0.8, v1, v2 et v3 ne seront plus supportées à partir de la version d’AOS et de Prism Central prévue au deuxième trimestre 2027. Le premier effet se voit dès pc.7.6 : les actions sur les Nutanix Guest Tools passent aux permissions v4, et les rôles personnalisés qui s’appuyaient sur les permissions v3 sont à mettre à jour. Si vos scripts parlent encore aux API v2 ou v3, il reste moins d’un an pour les migrer vers les API v4…

Vous savez tout, il ne vous reste plus qu’à lancer vos LCM !

Read More
State of the Lab : mon homelab Nutanix avant la refonte

En septembre 2024, je publiais un article sur la création d’un homelab sous Nutanix CE dans lequel j’écrivais que la première question à se poser était celle de l’usage : des machines virtuelles éphémères pour monter en compétence, ou des services pour soi et pour sa famille ? J’avais répondu « des tests », et j’ai construit toute mon infrastructure autour de cette réponse.

Deux ans plus tard, la réponse a changé et l’infrastructure, elle, n’a pas bougé. Avant d’entamer le chantier, voici à quoi ressemblait mon homelab Nutanix au 1er juillet 2026.

L’état des lieux de mon homelab Nutanix au 1er juillet 2026

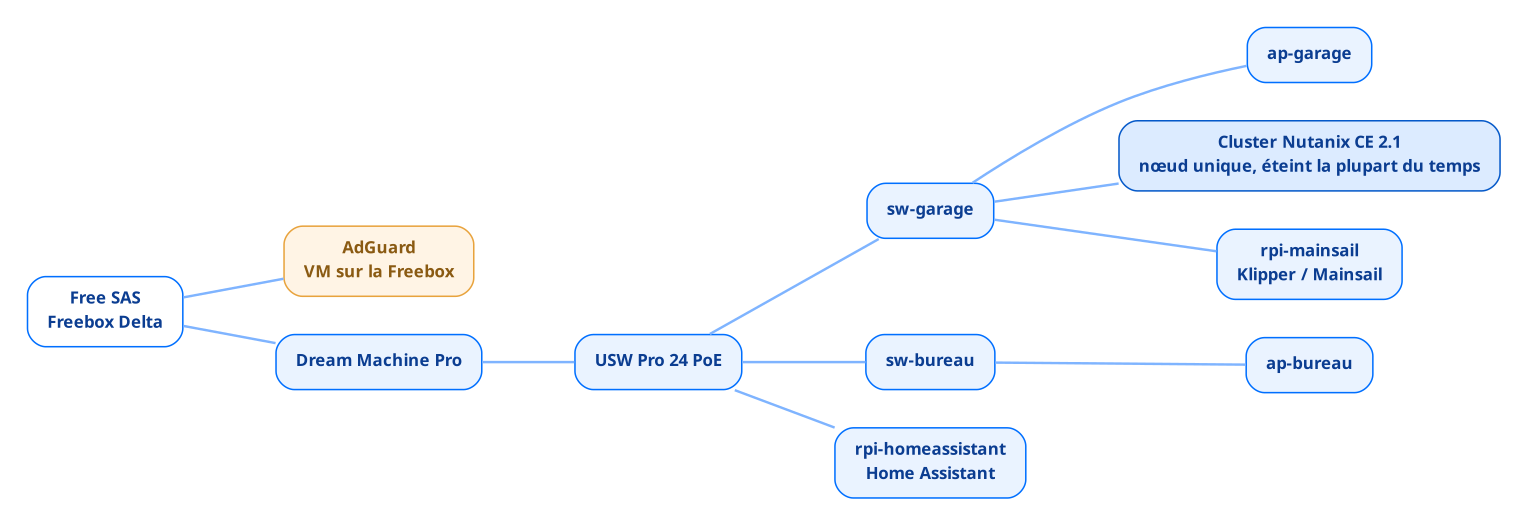
À cette date, tout ce qui tourne chez moi tient sur trois machines. Le réseau d’abord, monté il y a quatre ans à la construction de la maison et entièrement basé sur du Ubiquiti : une Dream Machine Pro, un switch USW Pro 24 PoE et quelques Flex répartis dans les pièces, le tout raccordé à une Freebox Delta en fibre 10 Gb/s.

Topologie du réseau domestique : Freebox Delta, Dream Machine Pro et USW Pro 24 PoE, avec le cluster Nutanix CE et Mainsail derrière le switch du garage, Home Assistant sur l'USW 24 et AdGuard dans une VM de la Freebox

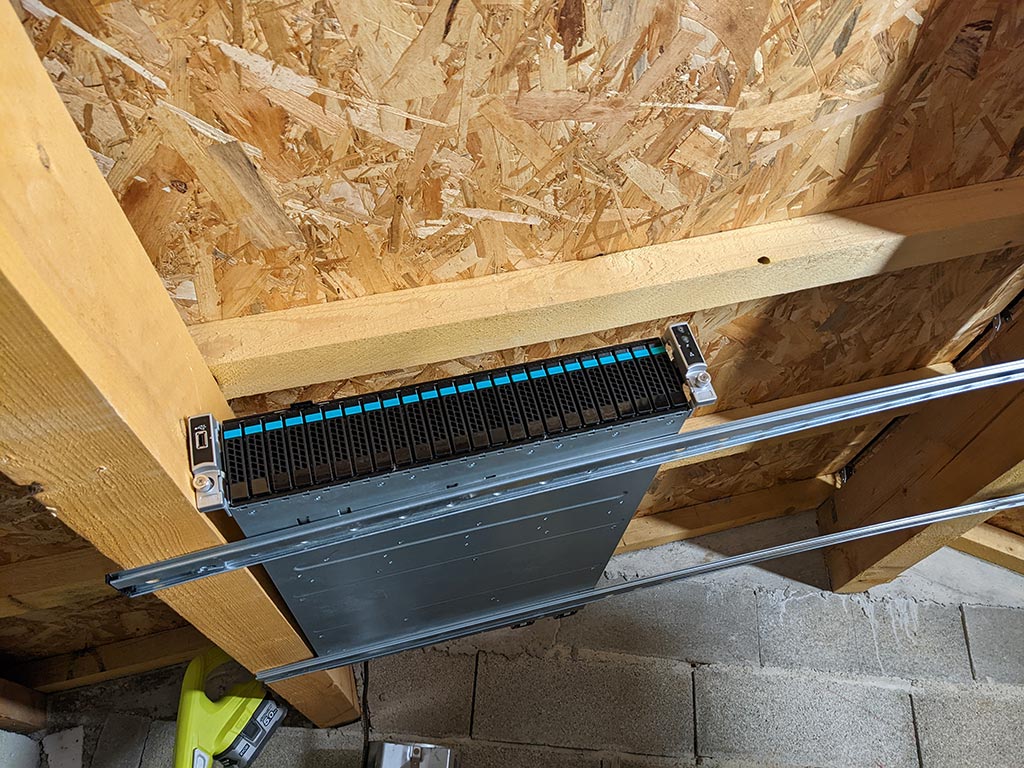
Le cluster ensuite, un châssis Intel S2600WTTR installé dans le garage parce qu’il n’a pas droit de séjour dans la maison, sur des rails coulissants vissés dans les solives faute de baie, un nœud unique sous Nutanix CE 2.1, avec deux ou trois machines virtuelles de test dessus. J’en ai détaillé la configuration matérielle à l’époque, je vous invite à consulter mon article à ce sujet.

Le châssis Intel S2600WTTR de mon cluster Nutanix CE, monté sur rails sous la structure bois du garage

Ce serveur de 2016, je l’ai récupéré dans une précédente expérience professionnelle. Il était tombé en panne matérielle et l’administration ne souhaitait pas engager la réparation, compte tenu de son âge et du remplacement de l’infrastructure déjà lancé vers des clusters Nutanix neufs. Je l’ai donc sorti et remis en état à mes frais.

Tout le reste des décisions matérielles découle de ce point de départ. Une seule alimentation raccordée sur les deux, volontairement, parce que rien de critique ne tourne dessus et qu’une panne se traduit au pire par un cluster arrêté le temps d’un week-end, puis une redondance disque partielle que j’assumais déjà à l’époque comme un compromis. Sur le dimensionnement en revanche, je n’ai jamais rencontré la moindre limite : 384 Go de RAM, quatre SSD SAS de 800 Go et six disques 10k pour deux ou trois machines virtuelles de test, de la marge qui ne servait à rien.

Et c’est tout, ou presque. Deux services vivent en dehors du cluster : Home Assistant sur un Raspberry Pi, qui collecte déjà la consommation de la prise Meross branchée sur le serveur et la production photovoltaïque de mon installation, et AdGuard sur une machine virtuelle hébergée par la Freebox. La résolution DNS de toute la maison reposait donc sur la box de mon opérateur : un redémarrage un peu long, un changement d’offre, et plus rien ne résout.

Ce que l’audit du réseau a montré

Avant de toucher au cluster, j’ai passé la configuration UniFi au crible, sur une version antérieure à UniFi OS 5.1.33. Le résultat est moins flatteur que le matériel.

Le réseau natif est en 192.168.2.0/24 et porte l’identifiant de VLAN 1 dans le contrôleur, un écart entre le nommage et la réalité qui pique dès qu’on relit une configuration six mois plus tard. Quatre SSID ensuite, tous en 2,4 GHz et tous en WPA2, dont un masqué pour la vidéoprotection, ce qui n’a jamais protégé personne et complique surtout la vie des équipements qui doivent s’y raccrocher. Les caméras Tapo, justement, sont en Wi-Fi sur ce même réseau natif : les appareils sur lesquels j’ai le moins de garanties partagent le segment de tout le reste.

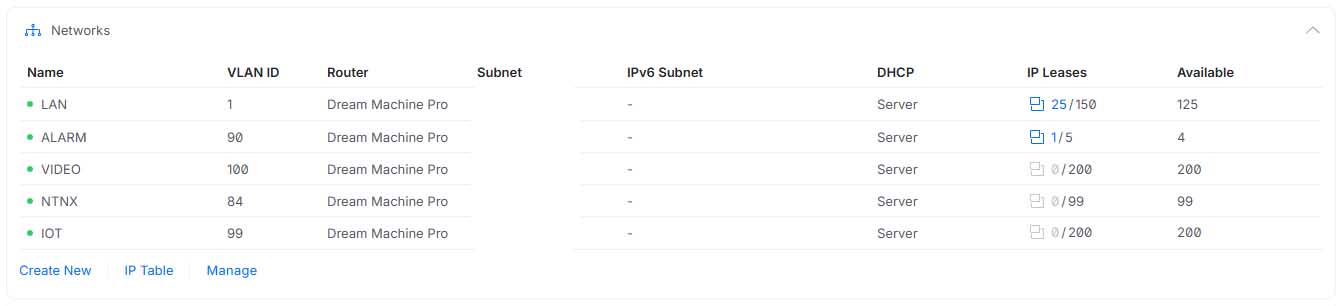
Liste des réseaux dans le contrôleur UniFi : le LAN en 192.168.2.0/24 porte l'identifiant de VLAN 1, et trois des quatre autres VLAN n'ont distribué aucun bail DHCP

L’inventaire a sorti le reste. Quatre VLAN déclarés à côté du natif, ALARM en 192.168.90.0/29, VIDEO en 192.168.100.0/24, NTNX en 192.168.84.0/24 et IOT en 192.168.99.0/24, dont trois n’ont jamais distribué le moindre bail DHCP. Pendant ce temps, vingt-cinq équipements se partagent le LAN, les caméras comprises, alors que le VLAN VIDEO qui leur est destiné existe depuis le premier jour et reste vide.

C’est ce qui arrive quand on dessine une segmentation le jour de l’installation et qu’on ne la relit plus jamais ensuite.

Il n’y a donc pas de segmentation, juste des VLAN déclarés. Et la raison est la même que pour le cluster : le temps est passé ailleurs.

Ce que coûte un homelab Nutanix qu’on n’allume qu’au besoin

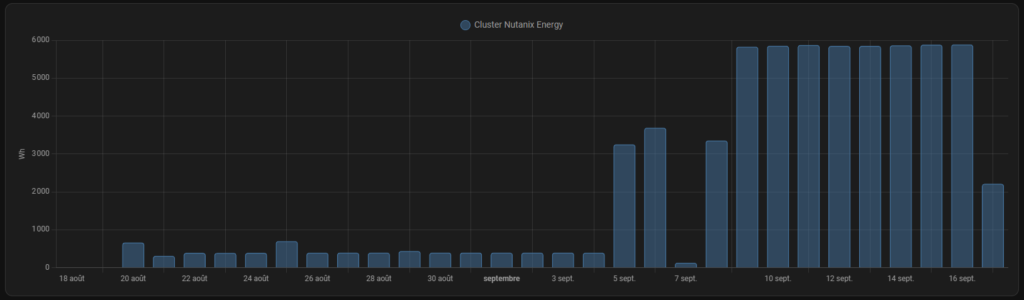
En 2024, j’avais branché une prise connectée Meross sur le cluster et je l’avais remontée dans Home Assistant pour savoir précisément ce que cette machine me coûtait. Environ 5 850 Wh par jour cluster allumé, ce qui projette 2 138,9 kWh sur une année pleine et près de 535 euros au tarif réglementé, en supposant le serveur allumé tous les jours de l’année.

Consommation quotidienne du cluster mesurée dans Home Assistant du 18 août au 17 septembre 2024 : un palier bas serveur éteint, puis des journées à près de 5 850 Wh à partir du 10 septembre

Le chiffre que je n’attendais pas est l’autre : le serveur éteint consomme encore entre 300 et 400 Wh par jour, uniquement pour maintenir l’IPMI et les alimentations sous tension. Rapporté à l’année, cela fait de 110 à 146 kWh et une trentaine d’euros pour une machine qui ne fait rien. Le détail de la mesure est dans l’article que j’ai consacré au sujet.

La règle s’est donc imposée d’elle-même : le cluster ne s’allume que pour les tests et pour la rédaction des articles. Et c’est exactement ce qui bloque tout le reste, puisqu’une infrastructure qu’on démarre le soir où on en a besoin ne peut héberger aucun service qui doit répondre en permanence, ce qui exclut à peu près tout ce qu’une maison attend d’un serveur.

J’ai laissé la situation en l’état pendant deux ans car j’avais d’autres chantiers sur le feu.

Ce qui n’existait pas

Au 1er juillet 2026, je n’avais ni DNS interne, ni reverse proxy, ni supervision, ni gestion des secrets, et aucun système de sauvegarde.

Chacun de ces manques est indolore tant que les machines virtuelles sont jetables. On accède à une VM par son adresse IP parce qu’on en a trois, on ne surveille rien parce qu’un arrêt ne dérange personne, et on ne sauvegarde pas ce qu’on a prévu de détruire à la fin du test.

Avec le temps, les besoins ont évolué et je veux aujourd’hui faire tourner des applications en local qui seront utilisées par toute la famille. Les cinq manques apparaissent alors d’un seul coup, parce qu’aucun d’eux ne se voit tant que rien n’a besoin de survivre à un redémarrage.

Le seul ajout en deux ans : Mainsail

Entre mon article de 2024 et aujourd’hui, une seule chose a bougé. En décembre 2025, j’ai installé Klipper et Mainsail pour piloter mon imprimante 3D, sur un Raspberry Pi posé à côté.

Je n’ai même pas envisagé d’autre option. AHV ne sait pas faire de passthrough USB, la KB Nutanix est claire là-dessus, et de toute façon le cluster passe l’essentiel de son temps éteint. Il reste une piste que je garde pour la refonte, VirtualHere, qui expose un périphérique USB sur le réseau et le présente à une machine virtuelle sans passthrough matériel. Je ne l’ai pas encore testée.

La facture d’électricité a fini par dicter l’architecture, et pendant deux ans elle a produit la même décision à chaque nouveau besoin.

Voilà l’état des lieux. Un cluster de test presque tout le temps éteint, deux Raspberry Pi qui hébergent des applications et une box opérateur qui fait office de serveur DNS. Ça fonctionne, et ça ne peut rien porter de plus.

Le chantier commence là. Il me faut un socle allumé en permanence et sobre, un DNS et un reverse proxy qui m’appartiennent, des sauvegardes vérifiées, de la supervision, de quoi gérer les secrets… et un cluster Nutanix qui redevient ce pour quoi il est bon : casser des choses. C’est ce que je vais raconter dans les articles qui suivent.

Read More
Retrouver un IPMI injoignable en IPv6 link-local

Ce week-end, j’ai voulu déplacer l’IPMI de mon node Nutanix de lab sur mon segment d’administration. J’ai changé l’adresse de la carte et le profil de VLAN du port du switch dans la même minute. Le node venait d’être réinitialisé, il n’avait plus de système, donc plus aucun moyen de corriger depuis l’intérieur, et la carte a disparu du réseau.

Ce qui m’a rendu la main tient en une adresse IPv6 link-local et deux commandes, un quart d’heure montre en main. Voici la méthode, sous Windows 11 et sous Rocky Linux.

Le soir où l’IPMI a disparu du réseau

Deux changements dans la même minute m’ont privé de tout moyen de savoir lequel des deux avait cassé quoi. J’ai branché un laptop en direct sur le port IPMI dédié de ce Supermicro SYS-5019D-4C-FN8TP pour reprendre la main.

Sur un node qui tourne, ipmitool en local règle ce genre de bêtise en une commande via l’interface KCS, sans passer par le réseau, mais un serveur fraîchement effacé ferme cette porte. Si vous êtes dans la situation inverse, la carte joignable mais le mot de passe perdu, je vous invite à consulter mon article à ce sujet : mot de passe IPMI perdu sur un noeud Nutanix ou Supermicro.

Pourquoi le link-local répond quand l’IPv4 est muette

Toute interface IPv6 active porte une adresse qui commence par fe80::, construite toute seule à partir de sa MAC et sans DHCP. Une machine dont l’IPv4 est fausse ou absente garde donc une identité joignable sur son segment. L’adresse ff02::1 est le groupe multicast dit all-nodes : un ping vers ce groupe fait répondre tout ce qui vit au bout du câble, et un IPMI alimenté en veille répond même serveur éteint. Le multicast ne traverse pas un routeur, il faut donc être sur le même segment que la carte.

Un détail achève de justifier la méthode, vu plus tard en relisant la configuration de ma carte en firmware 01.74.13 : la ligne « ARP Responses Enabled, Gratuitous ARP Disabled ». L’IPMI ne s’annonce jamais spontanément, donc écouter passivement le segment ne mène nulle part.

Retrouver la carte sur le câble

Le principe est le même sur les deux systèmes : identifier l’interface, envoyer le multicast, lire le cache voisinage.

Sous Windows 11

  • Repérage de la carte et de son index :
Get-NetAdapter

La colonne ifIndex donne le numéro à réutiliser ensuite, l’index 3 chez moi.

Sur un lien direct il n’y a aucun serveur DHCP, et une interface restée en automatique bascule en APIPA sur 169.254.x.x, auquel cas rien ne pinguera jamais, même face à un IPMI en parfait état. Posez une adresse statique :

New-NetIPAddress -InterfaceAlias "Ethernet" -IPAddress 192.168.10.50 -PrefixLength 24
  • Envoi du multicast, avec l’index de l’interface en suffixe de zone :
ping -6 ff02::1%3
  • Lecture des voisins découverts, avec leur adresse MAC :
Get-NetNeighbor -InterfaceIndex 3

Sous Rocky Linux

  • Identification de l’interface :
ip link show
  • Envoi du multicast :
ping6 -c4 ff02::1%ens0
  • Retour de la commande :
PING ff02::1%ens0(ff02::1%ens0) 56 data bytes
64 bytes from fe80:0:0:0:225:90ff:feb8:f313%ens0: icmp_seq=1 ttl=64 time=0.659 ms
64 bytes from fe80:0:0:0:225:90ff:feb8:f313%ens0: icmp_seq=2 ttl=64 time=0.288 ms
  • Association des adresses à leur MAC :
ip -6 neigh show dev ens0

Une nuance fait perdre du temps quand on passe d’un système à l’autre : le suffixe de zone prend un nom d’interface sous Linux et un index numérique sous Windows, et une adresse copiée d’une console à l’autre échoue sans message explicite.

Lire le constructeur directement dans l’adresse

Quand une adresse link-local contient ff:fe en son milieu, elle dérive de la MAC par la méthode EUI-64, et l’opération s’inverse de tête. Retirez les deux octets ff:fe du centre de fe80::225:90ff:feb8:f313, il reste 02:25:90:b8:f3:13, puis inversez le deuxième bit du premier octet : 02 devient 00, soit un OUI Super Micro Computer.

Ouvrir l’interface web en link-local

L’adresse récupérée s’utilise telle quelle dans un navigateur, entre crochets et suivie de son suffixe de zone :

https://[fe80::225:90ff:feb8:f313%3]

Le suffixe est obligatoire, une adresse link-local n’étant unique que sur un segment donné. Si votre navigateur refuse ce format, curl confirmera que le service répond, avec le % échappé en %25 et l’option -g sans laquelle les crochets partent en globbing :

curl -k -g "https://[fe80::225:90ff:feb8:f313%25ens0]/"

Ce que l’IPMI m’a révélé

Une fois l’interface ouverte, la réponse tenait en une ligne de sa page réseau : la carte portait 192.168.10.11, quand je pensais avoir configuré 192.168.10.1. Le profil de VLAN du port n’y était pour rien, et l’adresse que j’avais saisie est celle de la machine qui héberge mon DNS. Reconfiguration sur la bonne adresse, et c’était reparti.

Mes cartes de gestion vivent maintenant dans une plage réservée en bas du segment, avec une exclusion DHCP en face, le node de lab en .1 et celui de production en .2. Et je m’applique une règle simple depuis : un seul changement à la fois, vérifié avant le suivant.

Read More
Problème de réinstallation de Nutanix Community Edition

Réinstallation d’un nœud Nutanix Community Edition sur du matériel qui portait déjà un AHV. L’installeur Phoenix démarre, détecte le matériel, puis s’arrête sur une traceback Python :

FATAL An exception was raised: Traceback (most recent call last):
  File "/root/phoenix/./phoenix", line 155, in <module>
    main()
  ...
  File "/root/phoenix/sysUtil.py", line 2086, in mount_ahv_lvm_volumes
    shell_cmd(['mount', '-t ext4', dev, target + mntpnt])
Exception: Failed command: [mount -t ext4 /dev/mapper/ahv-varlog /mnt/stage/var/log]
with error: [mount: /mnt/stage/var/log: special device /dev/mapper/ahv-varlog does not exist.]

Le message semble parfaitement exact, et c’est ce qui le rend trompeur : le périphérique n’existe pas. La vraie question est de savoir pourquoi Phoenix le cherche.

Comprendre pourquoi l’installeur Nutanix plante

La pile d’appels raconte toute l’histoire, à condition de la lire de bas en haut :

  • get_params → determine_actions → get_hyp_state
  • get_hyp_state → customize_kvm.get_state → __mount_kvm_partition → mount_ahv_lvm_volumes

Phoenix ne plante pas pendant l’installation. Il plante avant, pendant la phase de détection, quand il essaie de déterminer quelles actions proposer. Il a trouvé un hyperviseur existant sur le disque, il a donc basculé sur son chemin customize (celui qui met à jour un AHV en place plutôt que d’en installer un neuf) et ce chemin exige de monter les volumes de l’installation existante.

Les lignes de log qui précèdent confirment le raisonnement :

INFO Calling dmsetup remove /dev/mapper/ahvstorage-varlogaudit
INFO Calling dmsetup remove /dev/mapper/ahvstorage-varlog
INFO LVM volume group ahv detected
INFO Found block device entry /dev/mapper/ahv-root, calling vgchange -an ahv

Deux groupes de volumes distincts apparaissent : ahv et ahvstorage. Un lvs depuis le shell de secours confirme la répartition :

LVVGTaille
homeahv200 Mo
rootahv6,84 Go
tmpahv1,95 Go
varahv2,93 Go
varlogahvstorage39,06 Go
varlogauditahvstorage1000 Mo

Voilà le décalage. Sur le disque, varlog vit dans le VG ahvstorage. L’ISO Phoenix, lui, cherche /dev/mapper/ahv-varlog, c’est-à-dire varlog dans le VG ahv. Il applique un schéma LVM qui n’est pas celui présent sur la machine.

L’explication la plus probable est un écart de génération : le layout AHV a évolué vers un VG de stockage séparé, et le média utilisé pour la réinstallation attend la disposition antérieure. Résultat, Phoenix reconnaît assez bien l’installation existante pour vouloir la réutiliser, mais pas assez pour savoir la monter.

La Solution : Faire table rase du disque système

Puisque le blocage tient entièrement à la détection d’une installation préexistante, la solution est de faire en sorte qu’il n’y ait plus rien à détecter.

Phoenix laisse un shell root accessible après l’échec. On commence par cartographier avant de détruire :

lsblk
pvs
vgs
lvs

Dans mon cas, deux PV sur un seul disque : /dev/sda3 pour ahv, /dev/sda5 pour ahvstorage.

Puis on démonte les VG et on les supprime :

vgchange -an ahvstorage
vgremove -f ahvstorage

ahvstorage disparaît sans résistance. ahv, lui, s’obstine :

Logical volume ahv/root contains a filesystem in use.
Can't deactivate volume group "ahv" with 2 open logical volume(s)

Le second problème : les volumes restés montés

Ce message est le vrai point de bascule de la procédure, et la sortie de lvs en donne la clé :

root  ahv  -wi-ao----
var   ahv  -wi-ao----

L’attribut o signifie open. Ces deux volumes logiques sont montés. Ce sont les « 2 open logical volume(s) » du message d’erreur, et c’est ce qui fait ensuite échouer toute la chaîne :

pvremove -ff -y /dev/sda3
  Can't open /dev/sda3 exclusively. Mounted filesystem?
  Cannot use /dev/sda3: device has a signature

wipefs -a /dev/sda
  wipefs: error: /dev/sda: probing initialization failed: Device or resource busy

La cause est simple : Phoenix avait monté root et var sous /mnt/stage avant de planter sur varlog, et il n’a rien démonté en sortant. L’échec a laissé le disque dans un état intermédiaire.

Il faut donc démonter avant tout le reste :

findmnt -R /mnt/stage
umount -R /mnt/stage

Si un processus tient encore la partition :

fuser -vm /mnt/stage
fuser -km /mnt/stage

On vérifie que les LV sont bien fermés, l’attribut doit être -wi-a-----, sans le o :

lvs

Et seulement ensuite, l’effacement complet :

vgchange -an ahv
vgremove -f ahv
pvremove -ff -y /dev/sda3
wipefs -a /dev/sda
sgdisk --zap-all /dev/sda
dd if=/dev/zero of=/dev/sda bs=1M count=100 conv=fsync

Le sgdisk --zap-all n’est pas décoratif. Une table GPT possède une copie de secours en fin de disque, que le dd sur les 100 premiers mégaoctets laisse parfaitement intacte. C’est la raison pour laquelle des groupes de volumes « reviennent » après un effacement qu’on croyait complet.

Si les disques de données CVM portent eux aussi des résidus, on leur applique le même traitement : wipefs -a puis sgdisk --zap-all sur chacun.

Reboot, relance de l’installeur, et Phoenix ne détecte plus rien : il propose une installation neuve.

Ce que je retiens de cette réinstallation

Un message d’erreur exact peut désigner le mauvais problème :

« ahv-varlog n’existe pas » est littéralement vrai et complètement hors sujet. Le problème n’est pas l’absence du volume, c’est que l’installeur applique un schéma qui n’est pas celui du disque. Sans lire la pile d’appels, on part chercher un volume manquant au lieu de comprendre qu’on est dans la mauvaise branche du programme.

Un échec d’installeur laisse un état :

Phoenix a planté après avoir monté deux volumes, et ces montages ont survécu à son arrêt. Tous les échecs de la séquence suivante (pvremove, wipefs) en découlaient directement. Avant de lutter contre un « Device or resource busy », il faut chercher ce qui tient le périphérique.

Un cluster explicitement destructible change la nature du problème :

Cette procédure est brutale : elle efface tout. Elle n’est acceptable que parce que ce nœud appartient à un environnement désigné comme sacrifiable, dont aucune donnée irremplaçable ne dépend. Décider à l’avance quel cluster est jetable ne change rien à la panne, mais change entièrement le temps qu’on passe à la résoudre.

Read More
Récupérer un mot de passe IPMI perdu sur un nœud Nutanix ou Supermicro

Il m’est arrivé une petite mésaventure récemment. Après un changement de mot de passe IPMI sur mon 1-node, impossible de me reconnecter à l’interface de management de mon nœud. Oubli dans la seconde ? Faute de frappe ? Copier coller foireux ? Qu’importe la raison, le verrouillage de l’accès, lui, était bien réel.

Perdre son mot de passe IPMI (ou BMC) fait souvent transpirer. Mais rassurez-vous, l’expérience m’a appris une règle d’or : tant que vous avez encore un accès au système d’exploitation de l’hôte (que ce soit AHV, un Linux standard ou même ESXi), vous pouvez récupérer la main sans avoir besoin de faire un reset matériel.

Toutefois, la situation peut être plus critique qu’il n’y paraît. Pour les experts qui me lisent, vous savez qu’en environnement Nutanix Single-Node, l’IPMI n’est pas juste un confort d’administration : c’est votre seul et unique fail-safe. Sans lui, impossible de monter une ISO Phoenix en Remote Media lors d’un crash AOS majeur ou pour forcer un redémarrage. Perdre l’accès BMC sur un tel nœud devient donc très vite un point de blocage impactant pour votre production et l’accès à la console distante.

Dans ce guide, je vous partage les différentes méthodes pour reprendre le contrôle sur votre noeud en quelques minutes, de la plus douce à celle de la dernière chance.

Méthode 1 : Réinitialisation in-band via ipmitool

Si vous êtes sous Nutanix AHV ou une distribution Linux classique, vous avez de la chance : l’utilitaire ipmitool est généralement présent nativement. L’astuce de cette méthode repose sur le canal matériel KCS (Keyboard Controller Style). En clair, cela permet à l’OS de l’hôte de communiquer directement avec la puce BMC via le bus de la carte mère (LPC/PCIe), sans passer par le réseau de management.

Identifier et écraser le compte Admin

Connectez-vous en root sur votre hôte. Par précaution, on s’assure d’abord que les modules noyaux gérant l’IPMI sont bien chargés :

modprobe ipmi_si
modprobe ipmi_devintf

Ensuite, on va lister les utilisateurs configurés (généralement sur le channel 1) pour repérer l’ID de notre compte administrateur. Dans 99% des cas, le compte par défaut (ADMIN) correspond à l’ID 2.

ipmitool user list 1

Dans mon cas, l’ID correspond bien à 2 :

Résultat de ipmitool user list 1 avec le compte ADMIN en ID 2

Une fois l’ID confirmé, la commande pour forcer un nouveau mot de passe est enfantine :

ipmitool user set password 2 'MonNouveauMdp123!'

Lors de la saisie de la commande précédente, il se peut que le terminal vous renvoie un vilain Invalid data field in request.

Pas de panique, c’est simplement le parseur de politique de sécurité de certains firmwares qui rejette votre demande. Il exige non seulement une complexité minimale (8 caractères, majuscule, minuscule, chiffre), mais peut aussi être capricieux sur le format de la requête.

Pour contourner (ou plutôt satisfaire) ce mécanisme, forcez la longueur d’encodage sur 20 octets en ajoutant simplement 20 à la fin de votre commande :

ipmitool user set password 2 'MonNouveauMdp123!' 20

Votre mot de passe est maintenant écrasé. Vous pouvez tester la connexion à l’interface web.

Méthode 2 : L’utilitaire IPMICFG (La solution pour VMware ESXi)

Si vous êtes sous VMware ESXi, la première méthode risque de vous laisser sur le carreau. Pourquoi ? Parce qu’ipmitool n’y est pas packagé nativement et résoudre les dépendances pour le compiler sur un hyperviseur est une perte de temps que je ne vous recommande pas.

La parade s’appelle IPMICFG. C’est l’outil officiel fourni par Supermicro (téléchargeable sur leur portail avec un compte gratuit). L’immense avantage est qu’il est fourni sous forme de binaires statiques, prêts à l’emploi pour Linux ou Windows.

Une fois l’archive transférée sur votre hôte et décompressée, son utilisation est très simple :

./IPMICFG-Linux.x86_64 -user list
./IPMICFG-Linux.x86_64 -user setpwd 2 MonNouveauMdp123!

Note : adaptez le nom du binaire si vous utilisez la version Windows ou Linux.

Vous pouvez récupérer l’utilitaire ici : https://www.supermicro.com/wdl/utility/IPMICFG/

Cas extrême : Le nœud n’a plus d’OS bootable

Que faire si l’OS ne démarre plus du tout ? C’est souvent là qu’on transpire, pensant que sans accès réseau à l’IPMI ni système d’exploitation fonctionnel, la seule méthode restante est le reset usine.

Rappelez-vous : l’interface KCS est exposée au niveau matériel dès la fin du POST BIOS. Elle est totalement indépendante de l’état de votre stockage.

Il suffit donc de booter le serveur sur une clé USB contenant un Live CD Linux (Ubuntu, Rocky Linux). Une fois sur le bureau éphémère, ouvrez un terminal, installez l’utilitaire s’il n’est pas déjà présent (apt install ipmitool par exemple), et reprenez exactement les commandes de la Méthode 1.

Méthode de dernier recours : Le Factory Reset du BMC

Si pour une raison obscure les méthodes précédentes échouent, il reste l’ultime recours : le reset aux paramètres d’usine.

Avec l’outil de Supermicro, la commande est directe :

./IPMICFG-Linux.x86_64 -fd

Et si vous préférez la méthode ipmitool pure, il faut passer une commande RAW :

ipmitool raw 0x3c 0x40

⚠️ Attention, les conséquences sont lourdes : Toute votre configuration BMC est remise à zéro. Vous perdez l’IP statique (le port repasse en DHCP), la configuration des VLANs, et vos comptes utilisateurs. Le BMC va ensuite redémarrer (comptez bien 2 à 3 minutes). Gros point de vigilance sur les générations récentes de serveurs : il se peut que le mot de passe ne redevienne pas ADMIN/ADMIN. Il bascule sur le mot de passe unique imprimé sur l’étiquette OCP (souvent collée sur le châssis ou la carte mère). Pensez-y si votre serveur est physiquement à l’autre bout du monde !

Mes recommandations

Une fois l’accès récupéré via la méthode 1 ou 2, voici ce que je fais systématiquement pour sécuriser mes arrières :

  1. Le gestionnaire de mots de passe : C’est basique, mais renseignez vos creds immédiatement au lieu de le garder dans le cache du copié-collé.
  2. Le compte de secours : Créez un second compte administrateur.
  3. L’astuce du Slot ID : Ne mettez pas votre compte de secours sur le Slot ID 3. Forcez sa création sur un Slot plus éloigné (comme le 5 ou le 6). Pourquoi ? Parce que certains scripts d’automatisation d’infrastructure ont parfois la fâcheuse tendance à écraser ou modifier en force les premiers Slots (2 et 3) lors du provisionning. En le mettant plus loin, vous le sanctuarisez.

Et vous, ça vous est déjà arrivé de vous enfermer dehors sur l’un de vos nœuds ? Partagez votre pire galère dans les commentaires ci-dessous !

Read More
VM Startup Policies sur Nutanix AHV

Il y a quelques années, suite à une panne de courant sur l’un de nos 2 sites, j’ai dû faire face à certaines problématiques applicatives après le redémarrage du cluster Nutanix. Sur le papier, tout aurait dû bien se passer : l’onduleur avait repris le relais, aucun impact sur la production mais c’était sans compter sur une mauvaise manipulation du technicien qui a coupé l’onduleur. Le cluster s’est brutalement arrêté.

Une fois le courant revenu, le cluster a redémarré automatiquement et l’ensemble des VMs a redémarré dans la foulée. Le problème, c’est que certains serveurs de bases de données ont pris leur temps… Trop de temps pour certaines applications métiers…

C’est exactement pour vous éviter ces sueurs froides nocturnes que nous allons explorer aujourd’hui les VM Startup Policies sur Nutanix AHV.

Si le concept d’ordonnancer le démarrage de ses serveurs peut paraître simple, la mécanique sous-jacente mérite qu’on s’y attarde.

Que sont les “VM Startup Policies” ?

Les VM Startup Policies sont une fonctionnalité native de l’hyperviseur AHV qui agit comme un ordonnanceur lors de l’allumage de vos machines virtuelles. Cette fonctionnalité a été ajoutée avec la version 7.5 dont je vous avais parlé il y a quelques temps sur le blog.

Écran d'accueil des VM Startup Policies dans Prism Central

Au lieu de subir l’ordre de démarrage et de laisser la main au cluster, vous définissez précisément des groupes de VMs et des règles de dépendances strictes. Ainsi, vous garantissez que vos services d’infrastructure (comme un Active Directory par exemple) et vos bases de données soient pleinement opérationnels avant d’autoriser le démarrage des serveurs applicatifs.

Pour bien comprendre l’importance de ces règles, un petit rappel du comportement par défaut d’Acropolis HA s’impose. En l’absence de Startup Policy, lors d’un crash de nœud ou d’un redémarrage de cluster, le redémarrage des VMs s’effectue en mode best-effort. Le cluster Prism Element se concentre sur l’allocation rapide des ressources (CPU/RAM) et déclenche l’allumage des VMs de manière totalement asynchrone et concurrente et n’a nativement aucune conscience de vos dépendances applicatives.

Dans quels cas ces règles s’activent-elles vraiment ?

Il est important de préciser que ces stratégies ne s’appliquent pas si vous décidez de redémarrer une VM manuellement depuis l’interface de Prism Central en pleine journée. L’orchestration AHV se réveille et applique vos Startup Policies dans deux cas de figure :

  1. Un événement de Haute Disponibilité (HA) : Un ou plusieurs nœuds physiques de votre cluster tombent en panne. L’hyperviseur AHV va rapatrier et redémarrer les VMs affectées sur les nœuds survivants, en respectant scrupuleusement l’ordre que vous avez défini.
  2. Un redémarrage complet du cluster (Full Cluster Restart) : Exactement le cas de mon anecdote ! Suite à une coupure électrique totale par exemple.

Décryptage de la mécanique : Les 3 piliers fondamentaux

L’approche de Nutanix a le mérite d’être extrêmement visuelle et très simple à prendre en main depuis Prism Central. Elle repose sur trois concepts fondamentaux.

1. Les Catégories

La mécanique de Nutanix s’appuie exclusivement sur les Catégories de Prism Central. Vous ne liez pas « Serveur-SQL-01 » à « Serveur-Web-01 », mais vous liez la catégorie AppMetier:Database par exemple aux VMs hébergeant des bases des données et vos VMs applicatives à la catégorie AppMetier:Applicatif.

C’est ici que réside la vraie puissance de cette architecture. Si demain vous déployez trois nouveaux serveurs applicatifs en scale-out pour absorber une charge imprévue, il vous suffit de leur assigner la bonne catégorie. Ils seront automatiquement intégrés dans le bon ordre de votre Startup Policy sans que vous n’ayez à ouvrir ou modifier la moindre règle.

2. Les niveaux de dépendances

C’est grâce à ça que vous dessinez votre chaîne logique : la catégorie B ne peut démarrer que si la catégorie A a terminé. Il y a tout de même une petite subtilité à garder en tête : Nutanix autorise un maximum de 6 niveaux de dépendance consécutifs par policy. Dans 99 % des cas, c’est largement suffisant pour une application classique (ex: Infra > BDD > Web), mais cela demande de bien regrouper ses services sans faire de micro-management.

Message Cannot add more than six groups to a policy

3. Les conditions de démarrage

C’est la question à un million : comment l’hyperviseur AHV sait-il que la base de données est réellement prête pour autoriser la suite ? L’outil vous propose 2 options :

  • VM Power On : Dès que la VM est sous tension au niveau matériel, on lance l’étape suivante. L’OS Windows ou Linux n’est même pas encore chargé. À éviter pour des dépendances fortes.
  • Guest Boot up : Le top du top ! Nutanix attend patiemment que l’OS soit complètement chargé et que la couche réseau réponde.

Pour que la condition « Guest Boot up » fonctionne, les Nutanix Guest Tools (NGT) doivent impérativement être installés et à jour sur la VM. Mon conseil (et la recommandation éditeur) : ne faites pas l’impasse sur le déploiement des NGT !

Il y a également une option qui complète l’une ou l’autre :

  • Delay (Délai en secondes) : On attend « bêtement » un temps donné (ex: 60 secondes) avant de passer à la suite.

Tutoriel : créer une startup policy

Je vous propose de modéliser l’exemple le plus courant : nous voulons démarrer nos contrôleurs de domaine, attendre qu’ils soient prêts, démarrer nos bases de données, puis enfin nos serveurs applicatifs.

Pour l’occasion, j’ai créé 3 catégories : AppType:ActiveDirectory, AppMetier:Database et enfin AppMetier:Applicatif

  1. Connectez-vous à Prism Central.
  2. Allez dans le menu Infrastructure > Compute > VMs > Policies > VM Startup Policies.
  3. Cliquez sur Create VM Startup Policy.
  4. Donnez-lui un nom explicite (ex: Policy-Tiering-Metier).
  5. Dans l’interface visuelle, ajoutez votre première catégorie (ex: AppType:ActiveDirectory).
  6. Ajoutez un second bloc pour AppMetier:Database et un troisième pour AppMetier:Applicatif.
  7. Cliquez sur + Configure Start Conditions pour définir les conditions de démarrage. Choisissez Guest Boot up et ajoutez éventuellement un délai de sécurité de 30 secondes pour laisser le temps aux services internes de l’OS de bien s’initialiser.

Cliquez sur “Create”, et le tour est joué !

Création d'une VM Startup Policy avec trois groupes de dépendance

Il ne vous restera plus qu’à ajouter vos VMs aux bonnes catégories.

Les pièges à éviter

L’outil est formidable, mais voici 3 retours terrains pour vous éviter de tomber dans certains pièges :

1. Gérer la limite des 6 niveaux intelligemment

Ne tombez pas dans le piège du micro-management ! Si vous essayez de faire une policy pour chaque micro-application, vous allez vite saturer l’interface, atteindre la fameuse limite des 6 niveaux et vous retrouver avec une usine à gaz impossible à maintenir dans le temps. Groupez intelligemment vos ressources et faites simple !

2. Attention à l’interaction avec les mécanismes de PRA

Les Startup Policies gèrent la résilience locale d’un cluster (HA ou reboot). Mais attention, si vous utilisez Nutanix Disaster Recovery pour basculer vers un site distant, ce système a son propre mécanisme de plans de reprise. Lors d’un failover inter-sites, c’est le Recovery Plan de Prism Central qui prend la main sur l’ordre de démarrage, et non plus votre Startup Policy locale. Veillez donc à maintenir une cohérence logique entre les deux outils.

3. Cela ne concerne que les VMs invitées

Inutile d’essayer de séquencer les VMs “Nutanix” (Prism Central, CVM, ou autres…), cela ne fonctionnera pas. Le mécanisme n’est applicable que sur vos machines virtuelles, pas celles du système.

Conclusion

Les VM Startup Policies sur Nutanix AHV sont le genre de fonctionnalité que l’on configure une fois, que l’on oublie, et qui peuvent faire gagner un temps et une sérénité précieux le jour où l’impensable se produit. Grâce à une interface visuelle intuitive basée sur des catégories, Nutanix a rendu la résilience applicative accessible à tous.

Si ce n’est pas déjà fait, je vous invite vivement à vérifier l’état de vos NGT (état de déploiement et versions) et à catégoriser vos VMs les plus critiques dès aujourd’hui. Votre futur « vous », réveillé à 3h du matin lors du prochain incident de prod, vous remerciera !

Read More
openclaw on nutanix ahv

Dans un précédent article, nous avons vu comment déployer OpenClaw sur Nutanix AHV. Cependant, avant de pouvoir profiter pleinement de cet agent IA autonome, il est crucial de préparer le terrain. OpenClaw n’est pas qu’un simple script : c’est un écosystème qui s’appuie sur plusieurs briques technologiques pour « penser » (LLM local), « exécuter » (Node.js) et « chercher » (SearXNG).

Schéma des prérequis OpenClaw : Ollama, SearXNG, Docker, Homebrew et GPU

Dans cet article, nous allons détailler l’installation pas-à-pas de tous les prérequis nécessaires sur votre machine virtuelle (sous Ubuntu), en expliquant pour chacun pourquoi il est indispensable au bon fonctionnement d’OpenClaw.

1. Pilotes NVIDIA : Libérer la puissance du GPU

OpenClaw peut s’appuyer sur des modèles de langage (LLM) exécutés localement. Bien qu’il soit techniquement possible de faire tourner ces modèles sur un processeur (CPU), les performances seraient extrêmement lentes. L’installation des pilotes NVIDIA permet au système d’exploiter la carte graphique (GPU) allouée à votre VM via Nutanix AHV (vGPU ou Passthrough), garantissant ainsi une inférence rapide et fluide de l’IA.

Voici comment mettre à jour votre système et installer les pilotes adéquats :

# Mise à jour du système
sudo apt update && sudo apt upgrade -y

# Installation du pilote serveur NVIDIA
sudo apt install nvidia-driver-535-server -y

# Redémarrage nécessaire pour la prise en compte
sudo reboot

Après le redémarrage, vérifiez que votre GPU est bien reconnu avec la commande suivante :

nvidia-smi

2. Node.js (v24) : Le moteur d’exécution d’OpenClaw

Le cœur de la logique d’OpenClaw est développé en JavaScript/TypeScript. Node.js est l’environnement d’exécution qui permet de faire tourner le code de l’agent, de gérer ses dépendances et d’orchestrer les appels entre l’interface, le modèle d’IA et les différents outils. Nous ciblons ici la version 24.x pour assurer une compatibilité optimale.

# Ajout du dépôt NodeSource et installation
curl -fsSL [https://deb.nodesource.com/setup_24.x](https://deb.nodesource.com/setup_24.x) | sudo -E bash -
sudo apt install -y nodejs

# Vérification de la version installée
node --version  # doit afficher v24.x

3. Ollama & Qwen 2.5 : Le cerveau local de l’opération

Ollama est l’outil qui va nous permettre de télécharger et de faire tourner facilement notre modèle d’IA en local. Pour OpenClaw, nous allons utiliser le modèle Qwen2.5 (7B). Pourquoi ce choix ? C’est un modèle léger (adapté pour les GPU avec environ 8 Go de VRAM) et, surtout, il est excellent en « Tool Calling » (l’appel d’outils). C’est cette capacité qui permet à OpenClaw de comprendre qu’il doit exécuter une recherche web ou lancer un script plutôt que de simplement générer du texte.

# Installation d'Ollama
curl -fsSL [https://ollama.ai/install.sh](https://ollama.ai/install.sh) | sh

# Démarrer le service Ollama (en arrière-plan)
ollama serve &

# Dans un autre terminal, vérifiez qu'Ollama détecte bien le GPU :
nvidia-smi  # Vous devriez voir ollama dans la liste des processus GPU

# Puller (télécharger) le modèle recommandé
ollama pull qwen2.5:7b

# Tester le modèle et vérifier son exécution sur le GPU
ollama run qwen2.5:7b "dis bonjour"

# Pendant que le modèle génère une réponse, vérifiez l'utilisation de la VRAM
nvidia-smi

4. Docker : L’infrastructure de conteneurisation

Afin d’étendre les capacités d’OpenClaw (notamment pour la recherche web que nous verrons juste après), nous avons besoin de services tiers. Docker permet de déployer ces services de manière isolée, standardisée et rapide, sans polluer notre système hôte avec de multiples dépendances complexes.

# Installation des dépendances initiales
sudo apt update
sudo apt install -y ca-certificates curl gnupg

# Ajout de la clé GPG officielle de Docker
sudo install -m 0755 -d /etc/apt/keyrings
curl -fsSL [https://download.docker.com/linux/ubuntu/gpg](https://download.docker.com/linux/ubuntu/gpg) | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
sudo chmod a+r /etc/apt/keyrings/docker.gpg

# Configuration du dépôt Docker
echo \
  "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] \
  [https://download.docker.com/linux/ubuntu](https://download.docker.com/linux/ubuntu) \
  $(. /etc/os-release && echo "$VERSION_CODENAME") stable" | \
  sudo tee /etc/apt/sources.list.d/docker.list > /dev/null

# Installation des paquets Docker
sudo apt update
sudo apt install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin

# Ajout de votre utilisateur au groupe docker pour éviter d'utiliser 'sudo' à chaque fois
sudo usermod -aG docker $USER
newgrp docker

# Vérification de l'installation
docker --version

5. SearXNG : Donner un accès au Web à l’IA

Pour qu’OpenClaw soit un véritable agent de recherche performant, il ne peut pas se contenter des données contenues dans le modèle Qwen (qui s’arrêtent à sa date d’entraînement). SearXNG est un métamoteur de recherche respectueux de la vie privée. En l’installant via Docker, nous offrons à OpenClaw une API (sur le port 8080) qu’il va pouvoir utiliser pour aller chercher en temps réel des informations sur le web et sourcer ses réponses.

# Créer un répertoire dédié pour la configuration
mkdir -p ~/searxng && cd ~/searxng

# Lancer le conteneur SearXNG
docker run -d \
  --name searxng \
  --restart unless-stopped \
  -p 8080:8080 \
  searxng/searxng

# Vérifier que le conteneur tourne correctement
docker ps

# Tester que l'API de SearXNG répond bien
curl http://localhost:8080

6. Homebrew & GCC : Les outils de compilation

L’écosystème Node.js d’OpenClaw fait parfois appel à des bibliothèques bas niveau ou à des packages natifs qui nécessitent d’être compilés directement sur votre machine lors de leur installation. Homebrew (le gestionnaire de paquets bien connu sur macOS, très pratique aussi sur Linux) et le compilateur GCC sont indispensables pour éviter les erreurs lors de la phase d’installation finale des dépendances (les fameux npm install).

# Installer le package de compilation de base Ubuntu
sudo apt-get install build-essential

# Installer Homebrew
/bin/bash -c "$(curl -fsSL [https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh](https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh))"

# Les instructions de fin d'installation d'Homebrew vous demanderont
# d'ajouter Homebrew à votre PATH. Généralement cela ressemble à ceci :
# (Assurez-vous d'adapter le chemin si nécessaire)
echo 'eval "$(/home/linuxbrew/.linuxbrew/bin/brew shellenv)"' >> /home/$USER/.bashrc
eval "$(/home/linuxbrew/.linuxbrew/bin/brew shellenv)"

# Installation de GCC via Homebrew
brew install gcc

Conclusion

Votre machine virtuelle sous Nutanix AHV est désormais un environnement riche et complet, équipé de pilotes GPU performants, d’un moteur d’exécution (Node.js), d’un LLM prêt à répondre (Ollama), d’un accès au Web (SearXNG) et des bons outils de compilation.

Le terrain est parfaitement préparé. Il ne vous reste plus qu’à finaliser l’installation de l’application elle-même en suivant la suite de notre guide sur OpenClaw.

Read More
header nutanix

Il y a quelques mois, j’avais rédigé un article concernant l’installation des NGT en CLI sur Linux.

Ayant récemment basculé vers Rocky Linux 10 pour les VM de mon lab, je me suis heurté à une problématique : la procédure utilisée jusqu’à présent ne fonctionne pas !

Sortie de la commande d'installation des NGT sur Rocky Linux 10

Voici comment contourner le problème…

Montage des Nutanix Guest Tools

Connectez vous à votre cluster Nutanix sur Prism Central, allez dans la liste des machines virtuelles, faites un clic droit sur la machine virtuelle sur laquelle vous souhaitez installer les NGT et cliquez sur « Install NGT » :

Menu Install NGT dans Prism Central

Sur l’écran suivant, dans mon cas pas besoin de changer quoi que ce soit, cliquez sur « Confirm and Enter Password » :

Options d'installation des NGT

On ne touche à rien sur cet écran, cliquez simplement sur « Skip and Mount » en bas à gauche :

Bouton Skip and Mount de l'installation des NGT

L’ISO est monté, on passe maintenant aux lignes de commande !

Installation des Nutanix Guest Tools (ex : Rocky Linux)

Voici les commandes à passer sur la machine virtuelle pour installer les Nutanix Guest Tools :

  • Mise à jour du système :
sudo dnf update -y && sudo dnf upgrade -y
  • Installation de python (si non présent sur la machine) :
sudo dnf install python3
  • Vérification de l’identifiant du lecteur :
blkid -L NUTANIX_TOOLS
  • Retour de commande:
/dev/sr0
  • Montage de l’ISO :
sudo mount /dev/sr0 /mnt
  • Passage en mode root

sudo su

  • Installation des NGT :
dnf install /mnt/installer/linux/ngt_rpm_installer/ngt_repo/nutanix-guest-agent-4.5.1-1.x86_64.rpm
Installation du paquet NGT avec dnf

  • Vérification de l’installation en ligne de commande :
yum list installed | grep 'nutanix-guest-agent'
Paquet nutanix-guest-agent 4.5.1 installé

Et coté Prism Central :

VM Rocky Linux 10.1 dans Prism Central
Read More